فهرست مطالب
- Responses API چیست و چه تفاوتی با روش قدیمی دارد؟
- پیشنیازهای راهاندازی OpenAI Responses API
- مرحله اول: ساخت پروژه و دریافت کلید API
- مرحله دوم: نصب کتابخانههای رسمی در پایتون و Node.js
- مرحله سوم: ارسال اولین درخواست به Responses API
- نمونه درخواست با پایتون
- نمونه درخواست با Node.js و curl
- مرحله چهارم: انتخاب مدل مناسب و شناخت GPT-6.1 Sol
- مرحله پنجم: فعالسازی Ultrafast و محاسبه هزینه واقعی
- تفاوت قیمت Standard و Ultrafast
- مرحله ششم: دریافت تدریجی پاسخ با استریم
- مرحله هفتم: اتصال ابزارهای جستجو و فراخوانی تابع
- نمونه کامل فراخوانی تابع
- مرحله هشتم: نگهداری وضعیت گفتوگوی چندمرحلهای
- مرحله نهم: کاهش هزینه با کش پرامپت و پردازش گروهی
- کش پرامپت چه زمانی فعال میشود؟
- Batch API برای چه کاری مناسب است؟
- مرحله دهم: مدیریت محدودیت نرخ، خطاها و تلاش مجدد
- مرحله یازدهم: امنیت کلید، دادهها و محل پردازش
- مرحله دوازدهم: ساخت دستیار پژوهشی قابل اجرا با پایتون
- مرحله سیزدهم: پایش مصرف و انتقال پروژه به محیط عملیاتی
- مقایسه Responses API و Chat Completions
- خطاهای رایج و راهحل عملی
- جمعبندی: از نمونه اولیه تا سرویس پایدار
اگر قصد دارید یک دستیار هوش مصنوعی، ابزار پژوهشی، سامانه پاسخگویی به مشتریان یا فرایند خودکار بسازید، اتصال به مدل زبانی فقط آغاز کار است. یک محصول واقعی باید بتواند پاسخ را بهتدریج نمایش دهد، از ابزارهای بیرونی استفاده کند، گفتوگو را ادامه دهد، هزینه را کنترل کند و هنگام بروز خطا از کار نیفتد. OpenAI Responses API این قابلیتها را در قالب یک رابط برنامهنویسی در اختیار توسعهدهندگان قرار میدهد.
در این راهنمای عملی، راهاندازی Responses API را در ۱۳ مرحله با پایتون و Node.js یاد میگیرید؛ سپس مدل GPT-6.1 Sol را به برنامه وصل میکنید، حالت Ultrafast را فعال میکنید، کش پرامپت را بررسی میکنید و یک دستیار پژوهشی قابل اجرا میسازید. آموزش بر کارکرد واقعی هر قابلیت، هزینههای آن و نکات امنیتی موردنیاز برای عرضه محصول تمرکز دارد.
برای آشنایی با مسیرهای یادگیری و کاربردهای گستردهتر، میتوانید به آکادمی هوش مصنوعی ایران مراجعه کنید. در ادامه، نخست یک برنامه ساده میسازیم و سپس آن را به ساختاری نزدیک به نیازهای محیط عملیاتی گسترش میدهیم.
Responses API چیست و چه تفاوتی با روش قدیمی دارد؟
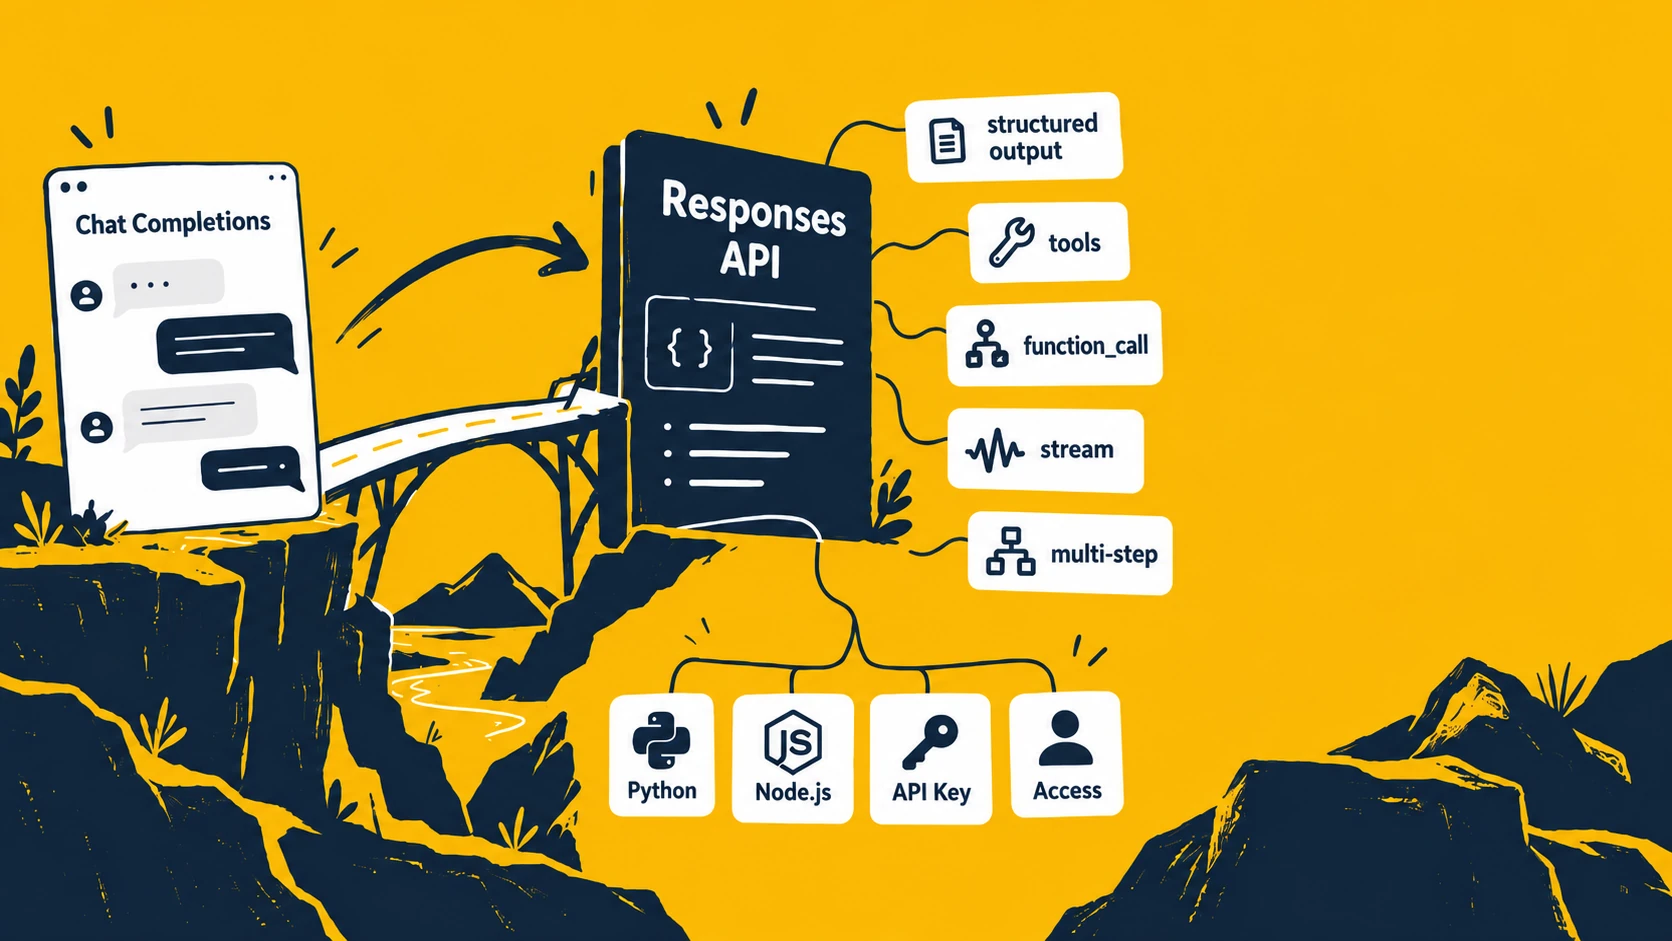
Responses API رابط یکپارچه OpenAI برای تولید متن و کار با خروجیهای ساختاریافته، ابزارهای داخلی، فراخوانی تابع و گفتوگوی چندمرحلهای است. درخواستها به نشانی https://api.openai.com/v1/responses ارسال میشوند. با فرستادن model و input، پاسخ دریافت میکنید؛ در صورت نیاز نیز میتوانید tools، stream، service_tier و تنظیمات دیگر را اضافه کنید.
در رابط قدیمی Chat Completions معمولاً با مجموعه پیامهای messages و خروجی choices[0].message.content کار میکنید؛ در Responses API ورودی با input و پاسخ متنی با response.output_text دریافت میشود. خروجی کامل فقط متن نیست و میتواند اجزایی مانند message، reasoning و function_call داشته باشد. به همین دلیل نباید فرض کرد تمام عناصر response.output پیام متنی هستند.
آیا Chat Completions حذف شده است؟ خیر. این رابط همچنان پشتیبانی میشود، اما OpenAI برای یکپارچهسازیهای تازه، مهاجرت تدریجی به Responses API را توصیه میکند. راهنمای رسمی مهاجرت به Responses API تفاوتها را توضیح میدهد.
پیشنیازهای راهاندازی OpenAI Responses API
پیش از آغاز، به حساب فعال در پلتفرم OpenAI، امکان استفاده از API و اعتبار پرداخت، کلید دسترسی، یک ویرایشگر کد و محیط اجرای پایتون یا Node.js نیاز دارید. برای اجرای نمونههای این مقاله، پایتون ۳.۱۱ یا جدیدتر و Node.js نسخه ۲۰ یا جدیدتر انتخاب مناسبی هستند. نسخه کتابخانهها را از مخازن رسمی بهروز نصب کنید؛ پشتیبانی از یک ویژگی به نسخه SDK نیز بستگی دارد.
اتصال ChatGPT در مرورگر و استفاده از API دو محصول با روش محاسبه هزینه جداگانه هستند. داشتن اشتراک ChatGPT لزوماً به معنی داشتن اعتبار API نیست. همچنین اجرای بعضی درخواستها از کشورها یا شبکههای خاص ممکن است مشمول محدودیتهای دسترسی OpenAI باشد؛ پیش از شروع، فهرست مناطق پشتیبانیشده را بررسی کنید.
مرحله اول: ساخت پروژه و دریافت کلید API
وارد داشبورد OpenAI شوید و یک پروژه مستقل برای آزمایش بسازید. جداسازی پروژه آزمایشی از محیط اصلی، پیگیری هزینه، مدیریت مجوزها و تعویض کلیدها را سادهتر میکند. سپس کلید API بسازید و آن را در فضای امن نگه دارید. کلید را در فایل عمومی، کد سمت مرورگر، مخزن گیت یا تصویر آموزشی قرار ندهید.
در مک و لینوکس میتوانید کلید را برای نشست جاری ترمینال تعریف کنید:
export OPENAI_API_KEY="کلید-محرمانه-شما"
در PowerShell ویندوز:
$env:OPENAI_API_KEY="کلید-محرمانه-شما"
در محیط عملیاتی از سامانه مدیریت اسرار استفاده کنید و برای پروژه، سقف هزینه و هشدار مصرف تعریف کنید. توجه داشته باشید سقف سخت هزینه میتواند با رسیدن به حد تعیینشده، درخواستهای بعدی را متوقف کند.
مرحله دوم: نصب کتابخانههای رسمی در پایتون و Node.js
برای پایتون بهتر است ابتدا محیط مجازی بسازید و سپس SDK رسمی را نصب کنید:
python -m venv .venv
# در مک و لینوکس:
source .venv/bin/activate
# در ویندوز:
# .venv\Scripts\activate
python -m pip install --upgrade openai
python -c "import openai; print(openai.__version__)"
برای Node.js در پوشه یک پروژه جدید:
npm init -y
npm install openai
کتابخانه رسمی را از منبع معتبر بگیرید. اگر هنگام استفاده از service_tier خطای ناشناختهبودن پارامتر گرفتید، نسخه نصبشده و مستندات SDK را بررسی کنید؛ پیش از تغییر کد مطمئن شوید مثال با نسخه مورد استفاده سازگار است.
مرحله سوم: ارسال اولین درخواست به Responses API
درخواست نخست را تا حد امکان ساده نگه دارید. این کار کمک میکند مشکلات احراز هویت و اتصال را از مشکلات مربوط به ابزارها یا تنظیمات پیشرفته جدا کنید.
نمونه درخواست با پایتون
فایلی با نام first_response.py بسازید:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6.1-sol",
input="در دو جمله توضیح بده رایانش ابری چیست."
)
print(response.output_text)
print("شناسه پاسخ:", response.id)
سپس دستور python first_response.py را اجرا کنید. اگر حساب، کلید و مدل در دسترس باشند، متن تولیدشده همراه با شناسه پاسخ نمایش داده میشود.
نمونه درخواست با Node.js و curl
در Node.js میتوانید فایلی با پسوند .mjs بسازید:
import OpenAI from "openai";
const client = new OpenAI();
const response = await client.responses.create({
model: "gpt-6.1-sol",
input: "در دو جمله توضیح بده رایانش ابری چیست."
});
console.log(response.output_text);
برای آزمایش بدون نصب SDK نیز این درخواست کافی است:
curl https://api.openai.com/v1/responses \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{"model":"gpt-6.1-sol","input":"سه کاربرد هوش مصنوعی در فروشگاه اینترنتی را نام ببر."}'
اگر درخواست موفق شود، خروجی JSON علاوه بر متن، اطلاعاتی درباره شناسه پاسخ، وضعیت و مصرف توکن خواهد داشت. برای جزئیات بیشتر به راهنمای آغاز کار OpenAI مراجعه کنید.
مرحله چهارم: انتخاب مدل مناسب و شناخت GPT-6.1 Sol
هر درخواست به قویترین یا سریعترین مدل نیاز ندارد. GPT-6.1 Sol برای بسیاری از وظایف پیچیده، توسعه نرمافزار و فرایندهای چندمرحلهای گزینهای میانی میان کیفیت و هزینه است. GPT-6 Astra برای کارهای دشوارتر و GPT-6 Luna برای بسیاری از وظایف پرتعداد و سادهتر قابل بررسی هستند؛ انتخاب نهایی باید با آزمون روی دادههای واقعی شما انجام شود.
مدل | ورودی استاندارد به ازای یک میلیون توکن | خروجی استاندارد به ازای یک میلیون توکن | کاربرد پیشنهادی |
|---|---|---|---|
GPT-6 Astra | ۱۰ دلار | ۵۰ دلار | مسائل دشوار و نیازمند دقت بالا |
GPT-6.1 Sol | ۲ دلار | ۱۰ دلار | برنامههای تعاملی و گردشکارهای پیچیده |
GPT-6 Luna | ۰٫۱۰ دلار | ۰٫۵۰ دلار | دستهبندی، استخراج ساده و پردازش پرتعداد |
این ارقام مربوط به حالت استاندارد و ورودی با طول متعارفاند؛ درخواستهای بسیار بلند، کش، منطقه پردازش و نوع خدمت میتوانند مبلغ نهایی را تغییر دهند. قیمت روز و محدودیت هر مدل را از صفحه رسمی قیمتگذاری OpenAI بررسی کنید.
برای مقایسه عملی، مجموعهای از ۲۰ درخواست واقعی با پاسخ مطلوب مشخص تهیه کنید. سپس کیفیت پاسخ، زمان دریافت اولین خروجی، زمان کاملشدن پاسخ و هزینه توکن را برای مدلها اندازه بگیرید. ارزانترین درخواست الزاماً اقتصادیترین نتیجه نیست؛ خطا و تکرار درخواست نیز هزینه دارند.
مرحله پنجم: فعالسازی Ultrafast و محاسبه هزینه واقعی
حالت Ultrafast سریعترین سطح پردازش API برای کارهایی است که تأخیر اهمیت زیادی دارد. در GPT-6.1 Sol با افزودن service_tier="ultrafast" آن را درخواست میکنید:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6.1-sol",
service_tier="ultrafast",
input="وضعیت استقرار نرمافزار را در یک جمله گزارش کن."
)
print(response.output_text)
print("سطح واقعی پردازش:", response.service_tier)
Ultrafast کیفیت پاسخ را بهطور خودکار بالاتر نمیبرد؛ هدف اصلی آن کاهش تأخیر تولید خروجی است. برای تجربههای زنده، کمکبرنامههای کدنویسی و AI Agentهای چندابزاری میتواند مفید باشد. البته ارسال درخواست با HTTP بهتنهایی همه مزیت سرعت را تضمین نمیکند. OpenAI برای جریانهای دارای چند فراخوانی پیاپی، استفاده از اتصال پایدار WebSocket را توصیه میکند.
تفاوت قیمت Standard و Ultrafast
طبق تعرفه اعلامشده برای GPT-6.1 Sol و ورودیهای با طول متعارف، قیمت هر یک میلیون توکن چنین است:
نوع توکن | Standard | Ultrafast |
|---|---|---|
ورودی عادی | ۲ دلار | ۱۲ دلار |
ورودی خواندهشده از کش | ۰٫۱۰ دلار | ۰٫۶۰ دلار |
نوشتن در کش | ۲٫۵۰ دلار | ۱۵ دلار |
خروجی | ۱۰ دلار | ۶۰ دلار |
بنابراین Ultrafast شش برابر تعرفه پایه استاندارد هزینه دارد؛ همچنین محدودیت نرخ آن از Standard و Fast جداست. برای بعضی مناطق پردازش نیز هزینه افزوده وجود دارد. پیش از فعالسازی سراسری، مستندات Ultrafast و بخش قیمتگذاری را بررسی کنید. بهترین راهکار معمولاً استفاده انتخابی از این حالت برای درخواستهایی است که کاربر در لحظه منتظر نتیجه است.
مرحله ششم: دریافت تدریجی پاسخ با استریم
در حالت عادی برنامه تا تکمیل پاسخ منتظر میماند. با stream=True میتوانید بخشهای خروجی را بهمحض تولید نمایش دهید. این روش زمان کاملشدن پردازش را لزوماً کم نمیکند، اما انتظار ادراکشده کاربر را کاهش میدهد:
from openai import OpenAI
client = OpenAI()
stream = client.responses.create(
model="gpt-6.1-sol",
service_tier="ultrafast",
input="سه راه کاهش زمان پاسخ یک برنامه هوش مصنوعی را توضیح بده.",
stream=True
)
for event in stream:
if event.type == "response.output_text.delta":
print(event.delta, end="", flush=True)
elif event.type == "response.completed":
print("\nپاسخ کامل شد.")
در برنامههای تحت وب، رویدادهای استریم را باید درست مدیریت کنید؛ برخی رویدادها مربوط به متن نیستند و ممکن است آغاز پاسخ، پایان درخواست، خطا یا فراخوانی ابزار را نشان دهند. برای متنهای قالببندیشده، نمایش تدریجی را طوری پیادهسازی کنید که نشانهگذاری ناقص باعث پرش رابط کاربری نشود.
مرحله هفتم: اتصال ابزارهای جستجو و فراخوانی تابع
مزیت مهم Responses API این است که مدل میتواند در کنار تولید متن، ابزار بهکار ببرد. با ابزار web_search امکان جستجوی اطلاعات روز فراهم میشود. با file_search میتوان از اسناد نمایهسازیشده بهره گرفت و با فراخوانی تابع، مدل میتواند از برنامه شما بخواهد عملیاتی مشخص انجام دهد.
نمونه جستجوی وب:
response = client.responses.create(
model="gpt-6.1-sol",
input="مهمترین تغییرات اخیر مستندات Responses API را با منبع خلاصه کن.",
tools=[{"type": "web_search"}]
)
print(response.output_text)
مدل بر اساس درخواست تصمیم میگیرد از ابزار استفاده کند یا نه. بهکارگیری جستجوی وب میتواند هزینه ابزار جداگانه داشته باشد و منابع نمایشدادهشده به کاربران باید قابل کلیک باشند. راهنمای جستجوی وب OpenAI جزئیات را شرح میدهد.
نمونه کامل فراخوانی تابع
فرض کنید کاربر وضعیت سفارش خود را میپرسد. ابتدا باید تابع مجاز را برای مدل تعریف کنیم؛ سپس فقط وقتی مدل درخواست فراخوانی داد، کد داخلی را اجرا کنیم و نتیجه را با call_id بازگردانیم:
import json
from openai import OpenAI
client = OpenAI()
def get_order_status(order_id):
# نمونه نمایشی؛ در برنامه واقعی باید مجوز دسترسی بررسی شود.
return {"order_id": order_id, "status": "در حال ارسال"}
tools = [{
"type": "function",
"name": "get_order_status",
"description": "وضعیت سفارش مجاز کاربر را برمیگرداند.",
"parameters": {
"type": "object",
"properties": {"order_id": {"type": "string"}},
"required": ["order_id"],
"additionalProperties": False
},
"strict": True
}]
first = client.responses.create(
model="gpt-6.1-sol",
input="وضعیت سفارش ۱۲۳۴ چیست؟",
tools=tools
)
for item in first.output:
if item.type == "function_call" and item.name == "get_order_status":
arguments = json.loads(item.arguments)
result = get_order_status(arguments["order_id"])
final = client.responses.create(
model="gpt-6.1-sol",
previous_response_id=first.id,
tools=tools,
input=[{
"type": "function_call_output",
"call_id": item.call_id,
"output": json.dumps(result, ensure_ascii=False)
}]
)
print(final.output_text)
توجه کنید مدل بهتنهایی به پایگاه داده شما دسترسی ندارد؛ اجرای تابع و کنترل مجوزها وظیفه برنامه است. در محیط واقعی باید مالکیت سفارش، ساختار ورودی، سقف تعداد فراخوانیها و ثبت وقایع بررسی شود. برای فرایندهای پیچیده میتوان این الگو را به یک AI Agent با چند ابزار گسترش داد.
مرحله هشتم: نگهداری وضعیت گفتوگوی چندمرحلهای
برای آنکه کاربر بتواند سؤال دوم را با توجه به پاسخ قبلی بپرسد، میتوان از شناسه درخواست پیشین استفاده کرد:
first = client.responses.create(
model="gpt-6.1-sol",
input="من در حال طراحی یک فروشگاه اینترنتی هستم.",
store=True
)
second = client.responses.create(
model="gpt-6.1-sol",
previous_response_id=first.id,
input="سه کاربرد هوش مصنوعی برای همین کسبوکار پیشنهاد بده.",
store=True
)
print(second.output_text)
پارامتر previous_response_id به برنامه کمک میکند ادامه گفتوگو را به پاسخ پیشین متصل کند؛ بااینحال توکنهای زمینه پیشین همچنان میتوانند در صورتحساب لحاظ شوند. اگر بنا به سیاست حفظ حریم خصوصی از store=False استفاده میکنید، نباید انتظار داشته باشید همین روش ارجاع به پاسخ ذخیرهنشده عمل کند؛ در این حالت تاریخچه لازم را خودتان مدیریت کنید. برای جریانهای طولانیتر، قابلیت Conversations API نیز قابل بررسی است. شرح این گزینهها در راهنمای مدیریت وضعیت گفتوگو آمده است.
مرحله نهم: کاهش هزینه با کش پرامپت و پردازش گروهی
در برنامه پرترافیک، هزینه نهایی فقط به مدل وابسته نیست؛ شکل ورودیها نیز نقش دارد. دو راه مهم برای کاهش هزینه، کش پرامپت و Batch API هستند. این دو سازوکار برای موقعیتهای متفاوتی طراحی شدهاند.
کش پرامپت چه زمانی فعال میشود؟
اگر بخش ابتدایی درخواستهای متعدد یکسان باشد، سامانه میتواند بخشی از پردازش آن پیشوند را دوباره استفاده کند. برای GPT-6.1 Sol دستکم ۱۰۲۴ توکن قابل مشاهده در پیشوند واجد شرایط لازم است. محتوای ثابت مانند دستورهای اصلی، تعریف ابزارها و مثالهای مشترک را ابتدای درخواست قرار دهید و اطلاعات متغیر کاربر را بعد از آن بفرستید.
instructions = """
شما دستیار پشتیبانی فارسی هستید.
پاسخها را روشن، کوتاه و بر اساس سیاستهای معتبر سازمان ارائه کنید.
"""
response = client.responses.create(
model="gpt-6.1-sol",
instructions=instructions,
input="چطور وضعیت درخواست پشتیبانی خود را ببینم؟"
)
print(response.output_text)
این کد فقط ساختار قرارگیری متن ثابت را نشان میدهد؛ چون پیشوند آن کوتاه است، نباید از آن انتظار دریافت تخفیف کش داشت. در GPT-6.1 Sol خواندن محتوای واجد شرایط از کش با نرخ کمتری محاسبه میشود، اما نوشتن اولیه در کش نیز هزینه جداگانه دارد. زمان نگهداری پیشفرض و شرایط بازاستفاده را از مستندات کش پرامپت بررسی کنید و میزان cached_tokens را در داده مصرف بسنجید.
Batch API برای چه کاری مناسب است؟
وقتی خروجی فوری لازم ندارید، مانند برچسبگذاری هزاران پیام، بررسی شبانه دادهها یا استخراج اطلاعات از مجموعه اسناد، پردازش گروهی مناسبتر است. Batch API درخواستها را بهشکل غیرهمزمان دریافت میکند، هزینه پردازش را نسبت به حالت استاندارد ۵۰ درصد کاهش میدهد و بازه انجام کار تا ۲۴ ساعت تعریف شده است. بنابراین برای گفتوگوی زنده مناسب نیست. اطلاعات اجرا و ساخت فایل درخواستهای گروهی در راهنمای رسمی Batch API قرار دارد.
مرحله دهم: مدیریت محدودیت نرخ، خطاها و تلاش مجدد
یک برنامه عملیاتی نباید با نخستین قطع اتصال متوقف شود. خطای ۴۰۱ معمولاً به احراز هویت مربوط است؛ خطای ۴۰۰ میتواند از پارامتر نامعتبر باشد؛ خطای ۴۲۹ ممکن است ناشی از محدودیت نرخ یا اعتبار و سقف مصرف باشد؛ و خطاهای ۵۰۰ یا ۵۰۳ اغلب به وضعیت موقت سمت سرویس مربوط میشوند.
همه خطاهای ۴۲۹ قابل حل با تکرار نیستند. اگر علت، پایان اعتبار یا رسیدن به سقف هزینه باشد، تلاش مجدد فقط درخواستهای ناموفق بیشتری تولید میکند. ابتدا نوع و کد خطا را بررسی کنید. SDK رسمی برای برخی خطاهای موقت بهصورت پیشفرض تلاش مجدد انجام میدهد؛ بنابراین از ساخت چند لایه تلاش مجددِ بیحساب خودداری کنید.
یک نمونه ساده برای کنترل تلاش مجدد از طریق تنظیمات خود کتابخانه:
from openai import OpenAI
client = OpenAI(
timeout=30,
max_retries=2
)
response = client.responses.create(
model="gpt-6.1-sol",
input="در یک بند درباره اهمیت ثبت خطا در سرویسها بنویس."
)
print(response.output_text)
در محیط عملیاتی، علاوه بر این تنظیمات، کد خطا، شناسه درخواست، میزان تأخیر و تعداد تلاشها را ثبت کنید. برای خطاهای موقت و زمانی که Retry-After وجود دارد، دستور سرور را رعایت کنید. راهنمای خطاهای OpenAI مرجع مناسب عیبیابی است.
مرحله یازدهم: امنیت کلید، دادهها و محل پردازش
امنیت فقط به مخفیکردن کلید API محدود نیست. پیش از ارسال اطلاعات کاربران، باید تعیین کنید چه دادههایی واقعاً برای پاسخ لازماند، چه کسی اجازه دسترسی دارد، خروجی ابزارها چگونه اعتبارسنجی میشود و چه اطلاعاتی در گزارشها باقی میمانند.
در Responses API، ذخیره وضعیت پاسخ بهصورت پیشفرض فعال است. store=False ذخیره پاسخ برای بازیابی بعدی از همین سازوکار را غیرفعال میکند؛ اما به معنی حذف تمام انواع ثبت و نگهداری داده در همه سامانههای عملیاتی نیست. سیاستهای پایش سوءاستفاده، تنظیمات سازمان و ویژگیهای فعال ممکن است قواعد جداگانهای داشته باشند. بر اساس سیاست اعلامشده OpenAI، دادههای ارسالی از طریق API بهصورت پیشفرض برای آموزش مدل استفاده نمیشوند، مگر آنکه مشتری بهطور صریح اجازه دهد.
در صورت نیاز قراردادی یا حقوقی به پردازش منطقهای، دسترسی به قابلیت اقامت داده برای مدل و نوع خدمت را بررسی کنید. برای GPT-6.1 Sol در Ultrafast، مناطق آمریکا و اتحادیه اروپا در مستندات ذکر شدهاند، ولی امکان استفاده عملی به تنظیمات و شرایط حساب بستگی دارد. مستندات کنترل دادهها باید مبنای تصمیم فنی و حقوقی شما باشد.
مرحله دوازدهم: ساخت دستیار پژوهشی قابل اجرا با پایتون
حالا میتوان قابلیتهای اصلی را در یک پروژه کوچک کنار هم قرار داد. این برنامه پرسش کاربر را میگیرد، در صورت نیاز از جستجوی وب استفاده میکند، پاسخ را تدریجی نمایش میدهد و با شناسه پاسخ قبلی، زمینه گفتوگو را حفظ میکند. برای هر درخواست، حالت پردازش بهصورت قابل تغییر در بالای فایل مشخص شده است.
فایل research_assistant.py را ایجاد کنید:
from openai import OpenAI, OpenAIError
MODEL = "gpt-6.1-sol"
SERVICE_TIER = "default" # برای آزمون سرعت: "ultrafast"
client = OpenAI(timeout=45, max_retries=2)
last_response_id = None
print("دستیار پژوهشی آماده است. برای خروج «خروج» را بنویسید.")
while True:
question = input("\nشما: ").strip()
if question in {"خروج", "exit", "quit"}:
break
if not question:
continue
try:
stream = client.responses.create(
model=MODEL,
service_tier=SERVICE_TIER,
input=question,
previous_response_id=last_response_id,
instructions=(
"شما دستیار پژوهشی فارسی هستید. پاسخ دقیق بده و "
"برای اطلاعات وابسته به زمان از جستجوی وب استفاده کن."
),
tools=[{"type": "web_search"}],
stream=True,
store=True,
)
print("دستیار: ", end="", flush=True)
next_response_id = None
for event in stream:
if event.type == "response.output_text.delta":
print(event.delta, end="", flush=True)
elif event.type == "response.completed":
next_response_id = event.response.id
elif event.type == "response.failed":
raise RuntimeError("ساخت پاسخ ناموفق بود.")
print()
if next_response_id:
last_response_id = next_response_id
else:
print("شناسه پاسخ جدید دریافت نشد؛ گفتوگو به حالت قبلی بازگشت.")
except (OpenAIError, RuntimeError) as error:
print(f"\nخطا در دریافت پاسخ: {type(error).__name__}")
برای اجرا:
python research_assistant.py
ابتدا با SERVICE_TIER = "default" آزمایش کنید. سپس مقدار را به "ultrafast" تغییر دهید و زمان، هزینه و تجربه کاربر را با همان سؤالها مقایسه کنید. این برنامه نمونه آموزشی است: برای استفاده عمومی باید احراز هویت کاربران، سهمیه مصرف، حفاظت در برابر ورودیهای مخرب، کنترل هزینه جستجوی وب و نمایش درست ارجاعات جستجو نیز اضافه شود.
مرحله سیزدهم: پایش مصرف و انتقال پروژه به محیط عملیاتی
موفقبودن اجرای یک نمونه روی لپتاپ به معنی آمادهبودن محصول نیست. پیش از انتشار، مصرف هر درخواست، تأخیر، خطا و هزینه را اندازه بگیرید. برای یک درخواست معمولی میتوان بخشی از آمار توکن را چنین مشاهده کرد:
response = client.responses.create(
model="gpt-6.1-sol",
input="یک تعریف کوتاه از یادگیری ماشین بنویس."
)
usage = response.usage
print("توکن ورودی:", usage.input_tokens)
print("توکن خروجی:", usage.output_tokens)
print("توکن ورودیِ کششده:", usage.input_tokens_details.cached_tokens)
برای عرضه پایدار، پروژه آزمایشی و اصلی را جدا کنید، کلیدهای مستقل بسازید، هشدار و سقف مصرف بگذارید، زمان پاسخ را از دید کاربر اندازه بگیرید و خطاها را با شناسه درخواست ثبت کنید. همچنین حد زمانی پاسخ، تعداد فراخوانی ابزار و دسترسی هر کاربر را محدود کنید. سنجه مهم فقط سرعت تولید توکن نیست؛ زمان تا اولین خروجی، زمان کاملشدن درخواست و نرخ موفقیت نیز باید اندازهگیری شوند.
از طرف دیگر، برای توسعه محصولات چندمرحلهای بهتر است فراخوانیهای API از یک لایه مشترک در برنامه عبور کنند تا تغییر مدل، سطح پردازش یا سیاست خطا به ویرایش بخشهای متعدد کد نیاز نداشته باشد. این رویکرد بهویژه در اتوماسیونهای کسبوکار اهمیت دارد.
مقایسه Responses API و Chat Completions
ویژگی | Responses API | Chat Completions |
|---|---|---|
ورودی اصلی | input | messages |
دسترسی به متن | response.output_text | choices[0].message.content |
خروجیهای ساختاریافته چندنوعی | بله، با آیتمهای دارای نوع | با ساختاری متفاوت |
ابزارهای میزبانیشده مانند جستجوی وب | پشتیبانی مستقیم | محدودتر و وابسته به روش اتصال |
ادامه گفتوگو | previous_response_id و روشهای دیگر | مدیریت پیامها یا سازوکارهای مکمل |
مسیر پیشنهادی برای پروژههای تازه | مناسبتر برای قابلیتهای جدید | همچنان پشتیبانی میشود |
در مهاجرت، تنها جایگزینکردن نشانی درخواست کافی نیست. باید قالب ورودیها، نحوه خواندن خروجی، رویدادهای استریم و سازوکار بازگرداندن نتیجه تابعها را نیز اصلاح کنید. برای جریانهای حساس، مهاجرت را مرحلهبهمرحله انجام دهید و کیفیت و هزینه را پیش و پس از تغییر مقایسه کنید.
خطاهای رایج و راهحل عملی
مشکل | علت احتمالی | اقدام پیشنهادی |
|---|---|---|
خطای ۴۰۱ | کلید نامعتبر یا بارگذارینشده | متغیر محیطی و دسترسی پروژه را بررسی کنید |
خطای ۴۰۰ هنگام Ultrafast | سطح پردازش یا مدل نامعتبر برای پروژه | مقدار service_tier و شرایط دسترسی را بررسی کنید |
خطای ۴۲۹ | نرخ درخواست، اعتبار یا سقف هزینه | کد دقیق خطا را بخوانید؛ فقط خطای موقت را دوباره تلاش کنید |
نبود خروجی استریم | پردازش نادرست رویدادها | نوع response.output_text.delta و رویدادهای پایان را کنترل کنید |
کاملنشدن فراخوانی تابع | بازنگرداندن نتیجه ابزار | function_call_output را با call_id درست ارسال کنید |
خطا در گفتوگوی بعدی | شناسه نامعتبر یا ذخیرهسازی غیرفعال | previous_response_id و سیاست نگهداری وضعیت را بررسی کنید |
نبود تخفیف کش | پیشوند کوتاه، تغییرپذیر یا منقضی | طول، یکسانبودن پیشوند و cached_tokens را بررسی کنید |
افزایش غیرمنتظره هزینه | استفاده گسترده از Ultrafast یا جستجوی وب | مدل، سطح پردازش و هزینه ابزارها را به تفکیک گزارش کنید |
جمعبندی: از نمونه اولیه تا سرویس پایدار
راهاندازی OpenAI Responses API با ساخت یک کلید و ارسال یک درخواست آغاز میشود، اما کیفیت محصول نهایی به تصمیمهای بعدی وابسته است: مدل درست را انتخاب کنید، Ultrafast را فقط جایی فعال کنید که ارزش اقتصادی دارد، پاسخ را تدریجی نمایش دهید، فراخوانی ابزارها را ایمن پیادهسازی کنید، وضعیت گفتوگو را آگاهانه مدیریت کنید و مصرف را در محیط عملیاتی بسنجید.
اگر هدف شما فقط اجرای چند خط کد نیست و میخواهید مهارتهای ساخت ابزارهای واقعی و اتوماسیون با هوش مصنوعی را توسعه دهید، مسیر یادگیری را از مبانی برنامهنویسی و کار با API تا ساخت AI Agent و ارزیابی محصول ادامه دهید. آکادمی هوش مصنوعی ایران میتواند نقطه شروع آشنایی با حوزههای آموزشی مرتبط باشد.
سوالات متداول
آیا OpenAI Responses API رایگان است؟
استفاده از API معمولاً بر اساس مصرف و تعرفه مدل یا ابزار محاسبه میشود. اشتراک ChatGPT لزوماً هزینه API را پوشش نمیدهد. برای آزمایش، سقف هزینه کوچکی تعیین کنید.
آیا Ultrafast برای تمام درخواستها مناسب است؟
خیر. Ultrafast برای زمانی ارزش دارد که سرعت پاسخ برای کاربر یا گردشکار حیاتی باشد. برای پردازشهای شبانه یا کارهایی که پاسخ فوری لازم ندارند، Standard، Flex یا Batch اغلب اقتصادیترند.
آیا میتوان از Responses API بدون پایتون استفاده کرد؟
بله. این رابط از طریق درخواست HTTPS قابل استفاده است و علاوه بر پایتون، کتابخانههای رسمی برای زبانهای دیگر نیز وجود دارد. نمونه Node.js و curl در همین آموزش آمده است.
آیا با store=False دادهای ذخیره نمیشود؟
این پارامتر ذخیره پاسخ برای بازیابی در سازوکار مربوط را غیرفعال میکند، اما نباید آن را معادل حذف کامل همه گزارشهای مرتبط با استفاده از سرویس دانست. سیاست نگهداری دادهها و نوع حساب را جداگانه بررسی کنید.
چگونه بفهمیم کش پرامپت کار کرده است؟
ابتدا اطمینان پیدا کنید پیشوند ثابت و به اندازه کافی بلند است. سپس در اطلاعات مصرف، مقدار usage.input_tokens_details.cached_tokens را بررسی کنید. وجود این مقدار نشان میدهد بخشی از ورودی از کش خوانده شده است؛ برای ارزیابی اقتصادی، هزینه نوشتن در کش را هم محاسبه کنید.
نظرات (۰)
هنوز نظری ثبت نشده است. اولین نفر باشید.