فهرست مطالب
- معمای ۲۵ ساله رمزنگاری از کجا آغاز شد؟
- چرا چند عدد میتوانند اعتماد به یک استاندارد امنیتی را زیر سؤال ببرند؟
- نقش NSA در شکلگیری نگرانیهای امنیتی
- Claude چگونه راز منحنیهای رمزنگاری NIST را کشف کرد؟
- سرنخی در نرمافزارهای قدیمی زبان C
- کشف ارتباط میان مولد اعداد و زمان یونیکس
- Claude منشأ کدام منحنیهای رمزنگاری را شناسایی کرد؟
- چرا منحنی P-256 اهمیت ویژهای دارد؟
- کشف دوم Claude؛ شناسایی منشأ نقاط پایه شش منحنی
- ردپای کتابخانه ریاضی FreeLIP
- آیا کشف Claude به معنای شکستهشدن رمزنگاری اینترنت است؟
- چرا کشف بذر منحنی به معنای افشای کلید خصوصی نیست؟
- آیا نگرانی درباره درهای پشتی NSA برطرف شده است؟
- چه بخشهایی از معمای رمزنگاری هنوز حل نشدهاند؟
- چرا این دستاورد برای آینده پژوهش با هوش مصنوعی مهم است؟
- تفاوت پاسخدادن با کشف یک نتیجه قابل بازتولید
- آیا هوش مصنوعی میتواند جای پژوهشگران انسانی را بگیرد؟
- سرنوشت جایزه ۳۶ هزار دلاری معمای رمزنگاری چه شد؟
- جمعبندی؛ Claude چه چیزی را تغییر داد؟
هوش مصنوعی Claude در کمتر از ۳۰ دقیقه موفق شد یکی از معماهای قدیمی دنیای رمزنگاری را رمزگشایی کند. این مدل با شناسایی منشأ پارامترهای پنج منحنی رمزنگاری استاندارد NIST، به پرسشی پاسخ داده است که بیش از دو دهه ذهن پژوهشگران امنیت سایبری را درگیر کرده بود. نکته جالب اینکه پاسخ معما نه در الگوریتمی محرمانه، بلکه در یک مولد اعداد شبهتصادفی قدیمی و ساعت کامپیوتر پنهان شده بود.
شرکت آنتروپیک (Anthropic) روز ۱۶ اکتبر ۲۰۲۶ از دستاوردی پژوهشی خبر داد که میتواند بخشی از ابهامهای تاریخی درباره استانداردهای رمزنگاری را برطرف کند. بهگفته این شرکت، مدلی پژوهشی از خانواده Claude توانسته است فرایند تولید پارامترهایی را بازسازی کند که در دهه ۱۹۹۰ میلادی بهوسیله آژانس امنیت ملی آمریکا (NSA) ارائه شده بودند.
این پارامترها سالها محل بحث بودند؛ زیرا روش انتخاب آنها بهطور عمومی توضیح داده نشده بود. همین مسئله باعث شد برخی متخصصان احتمال دهند انتخاب این اعداد شاید کاملاً تصادفی نبوده و ضعفهای عمدی در آنها پنهان شده باشد.
حالا یافتههای تازه نشان میدهند منشأ بخش مهمی از این اعداد بسیار سادهتر از چیزی است که تصور میشد.
البته ماجرا یک تفاوت اساسی با آنچه ممکن است از تیترهای هیجانانگیز برداشت شود دارد: Claude هیچ الگوریتم رمزنگاری را نشکسته و راه تازهای برای دسترسی به اطلاعات محرمانه کاربران پیدا نکرده است. این دستاورد بیشتر از آنکه زنگ خطری امنیتی باشد، پاسخی محاسباتی به پرسشی تاریخی است.
معمای ۲۵ ساله رمزنگاری از کجا آغاز شد؟
برای درک اهمیت این کشف، باید به سال ۲۰۰۰ میلادی برگردیم؛ زمانی که مؤسسه ملی استانداردها و فناوری آمریکا یا NIST، مجموعهای از منحنیهای بیضوی را در استاندارد امضای دیجیتال FIPS 186-2 معرفی کرد.
رمزنگاری منحنی بیضوی یکی از روشهای مهم در امنیت کلید عمومی به شمار میرود. این فناوری بر ویژگیهای ریاضی نقاط یک منحنی تکیه دارد و میتواند با کلیدهایی نسبتاً کوچک، سطح امنیت مناسبی فراهم کند.
یکی از شناختهشدهترین کاربردهای آن، الگوریتم امضای دیجیتال منحنی بیضوی یا ECDSA است. امضاهای دیجیتال برای تأیید اصالت دادهها و تشخیص تغییرات غیرمجاز استفاده میشوند و در بسیاری از سامانههای ارتباطی و نرمافزاری نقش دارند.
اما امنیت این الگوریتمها تنها به پیچیدگی محاسبات وابسته نیست. پارامترهای عمومی که مبنای عملیات ریاضی قرار میگیرند نیز باید بهدرستی انتخاب شوند.
چرا چند عدد میتوانند اعتماد به یک استاندارد امنیتی را زیر سؤال ببرند؟
برای ساخت یک منحنی بیضوی استاندارد، باید چند پارامتر ریاضی مشخص شود. این مقادیر ویژگیهای منحنی و نوع محاسباتی را تعیین میکنند که کاربران میتوانند روی آن انجام دهند.
در استانداردهای مورد بحث، مقداری به نام «بذر» منتشر شده بود که از طریق تابع هش در تعیین یکی از ضرایب معادله منحنی نقش داشت.
مشکل اینجا بود که مشخص نبود خود بذر از کجا آمده است.
پژوهشگران میتوانستند بررسی کنند که آیا پارامترهای نهایی با بذر منتشرشده سازگار هستند یا خیر؛ اما نمیتوانستند توضیح دهند چرا همان بذر از میان بیشمار گزینه ممکن انتخاب شده است.
در چنین شرایطی، یک پرسش مطرح میشود: آیا سازنده استاندارد میتوانسته پارامترها را با هدف دستیابی به ویژگی پنهان خاصی انتخاب کند؟
وجود این احتمال به معنای اثبات در پشتی نیست، اما برای ایجاد تردید درباره شفافیت فرایند طراحی کافی بود.
نقش NSA در شکلگیری نگرانیهای امنیتی
پارامترهای مورد بحث از سوی آژانس امنیت ملی آمریکا در اختیار NIST قرار گرفته بودند. بااینحال، توضیح روشنی درباره فرایند تولید بذرها منتشر نشده بود.
در طول سالهای بعد، پژوهشگران مختلف به بررسی این موضوع پرداختند. نیل کوبلیتز و آلفرد منزس نیز در پژوهش «معمایی در دل یک راز»، تاریخچه این نگرانیها را بررسی کردند.
یکی از روایتهای قدیمی به جری سولیناس، از کارکنان پیشین NSA، مربوط میشد. او در سال ۲۰۱۵ گفته بود که احتمالاً بذرها با استفاده از تابع هش و عبارتی طنزآمیز تولید شدهاند.
بااینحال، جزئیات دقیق فرایند در دسترس نبود و تلاش برای پیدا کردن آن عبارت نیز به نتیجه نرسید.
پس از گذشت سالها، این پرسش همچنان باقی مانده بود که اعداد منتشرشده دقیقاً چگونه ساخته شدهاند.
Claude چگونه راز منحنیهای رمزنگاری NIST را کشف کرد؟
براساس گزارش رسمی آنتروپیک، یکی از کارکنان این شرکت در اکتبر ۲۰۲۶ از یک مدل پژوهشی داخلی Claude خواست منشأ بذرهای رمزنگاری را بررسی کند.
برخلاف بررسیهای قبلی، مدل از ابتدا روی فرضیه وجود یک عبارت محرمانه یا طنزآمیز تمرکز نکرد.
Claude مسئله را از زاویه دیگری بررسی کرد: اگر برنامهنویسان دهه ۱۹۹۰ میخواستند چنین اعدادی تولید کنند، احتمالاً از چه ابزارهایی استفاده میکردند؟
این تغییر زاویه نگاه، نخستین قدم مهم برای حل معما بود.
سرنخی در نرمافزارهای قدیمی زبان C
در دهه ۱۹۹۰، بسیاری از برنامهها برای تولید اعداد ظاهراً تصادفی از مولدهای شبهتصادفی موجود در کتابخانههای برنامهنویسی استفاده میکردند.
این مولدها برخلاف منابع واقعی تصادفیبودن، خروجی خود را با استفاده از روابط ریاضی و یک مقدار اولیه تولید میکنند.
اگر الگوریتم و وضعیت اولیه مشخص باشند، خروجی آنها قابل بازتولید است.
Claude با بررسی ساختار بذرهای منتشرشده، احتمال داد که ردپای یکی از همین مولدهای قدیمی در اعداد وجود داشته باشد.
مدل برنامهای برای بررسی دنبالههای عددی نوشت و ۳۴ ترکیب مختلف از مولدها و روشهای استخراج خروجی را آزمایش کرد.
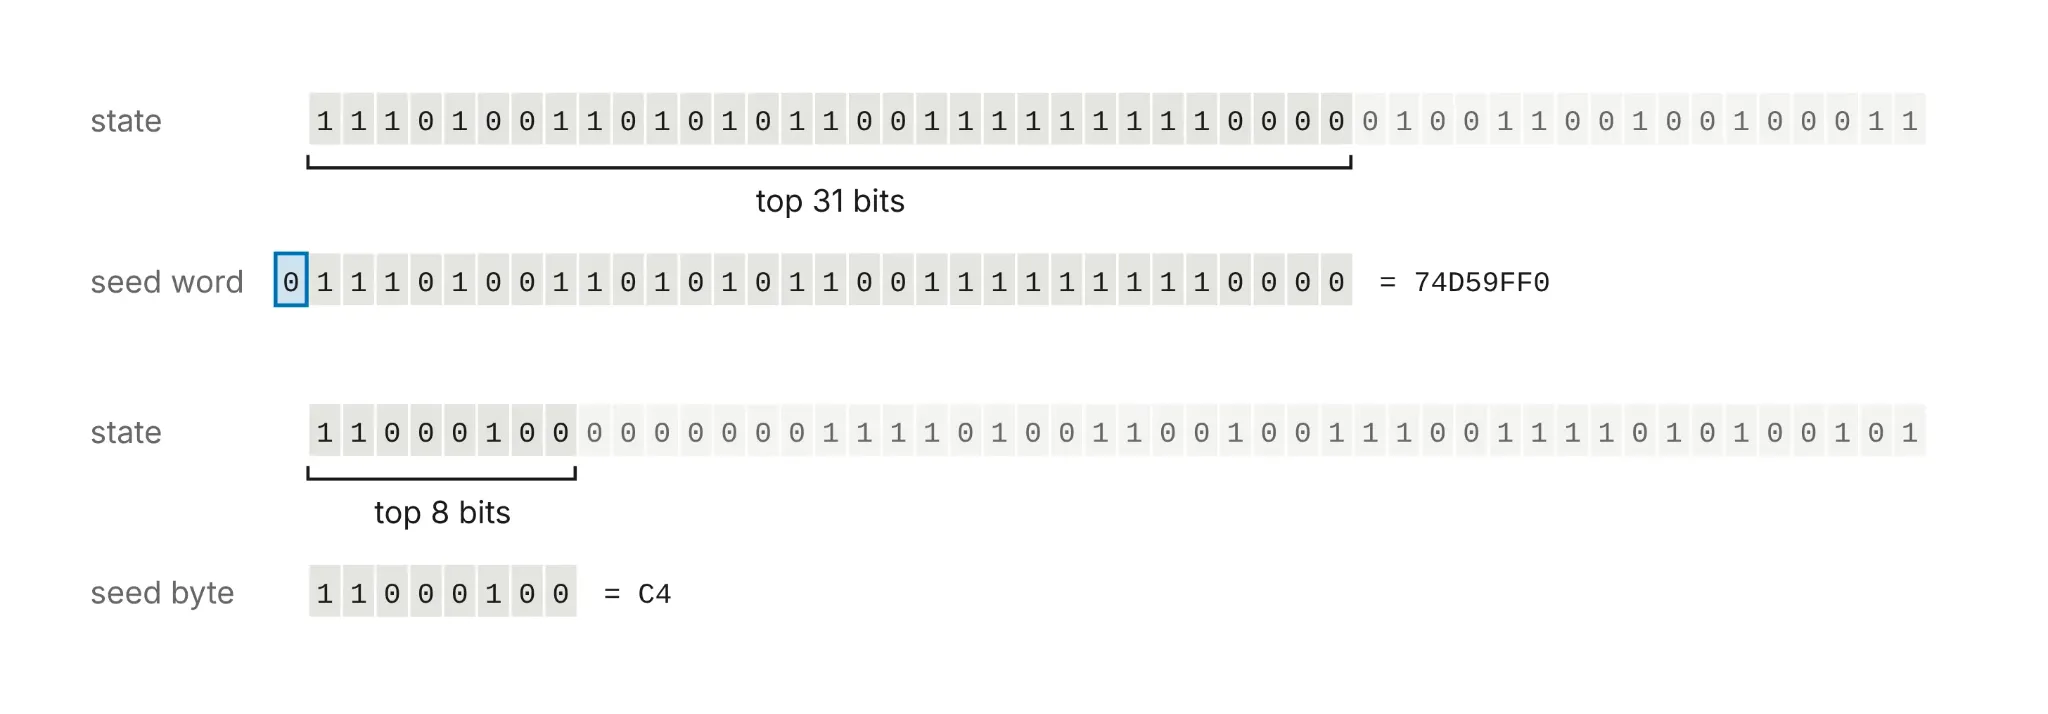
در جریان این بررسی، الگویی جلب توجه کرد: بیتهای بالایی تعدادی از مقادیر همگی صفر بودند.
احتمال مشاهده چنین الگویی بهصورت اتفاقی، مطابق محاسبات گزارششده، حدود یک در ۵۸۱۰ بود.
این ویژگی با رفتار مولد اعداد شبهتصادفی lrand48 سازگاری داشت؛ مولدی که در کتابخانه استاندارد زبان C وجود دارد.
کشف ارتباط میان مولد اعداد و زمان یونیکس
پس از شناسایی مولد احتمالی، Claude تلاش کرد وضعیت داخلی آن را بازسازی کند.
در بخشی از محاسبات، مدل از الگوریتم ریاضی LLL استفاده کرد؛ روشی برای کاهش پایه شبکه که در حل برخی مسائل محاسباتی کاربرد دارد.
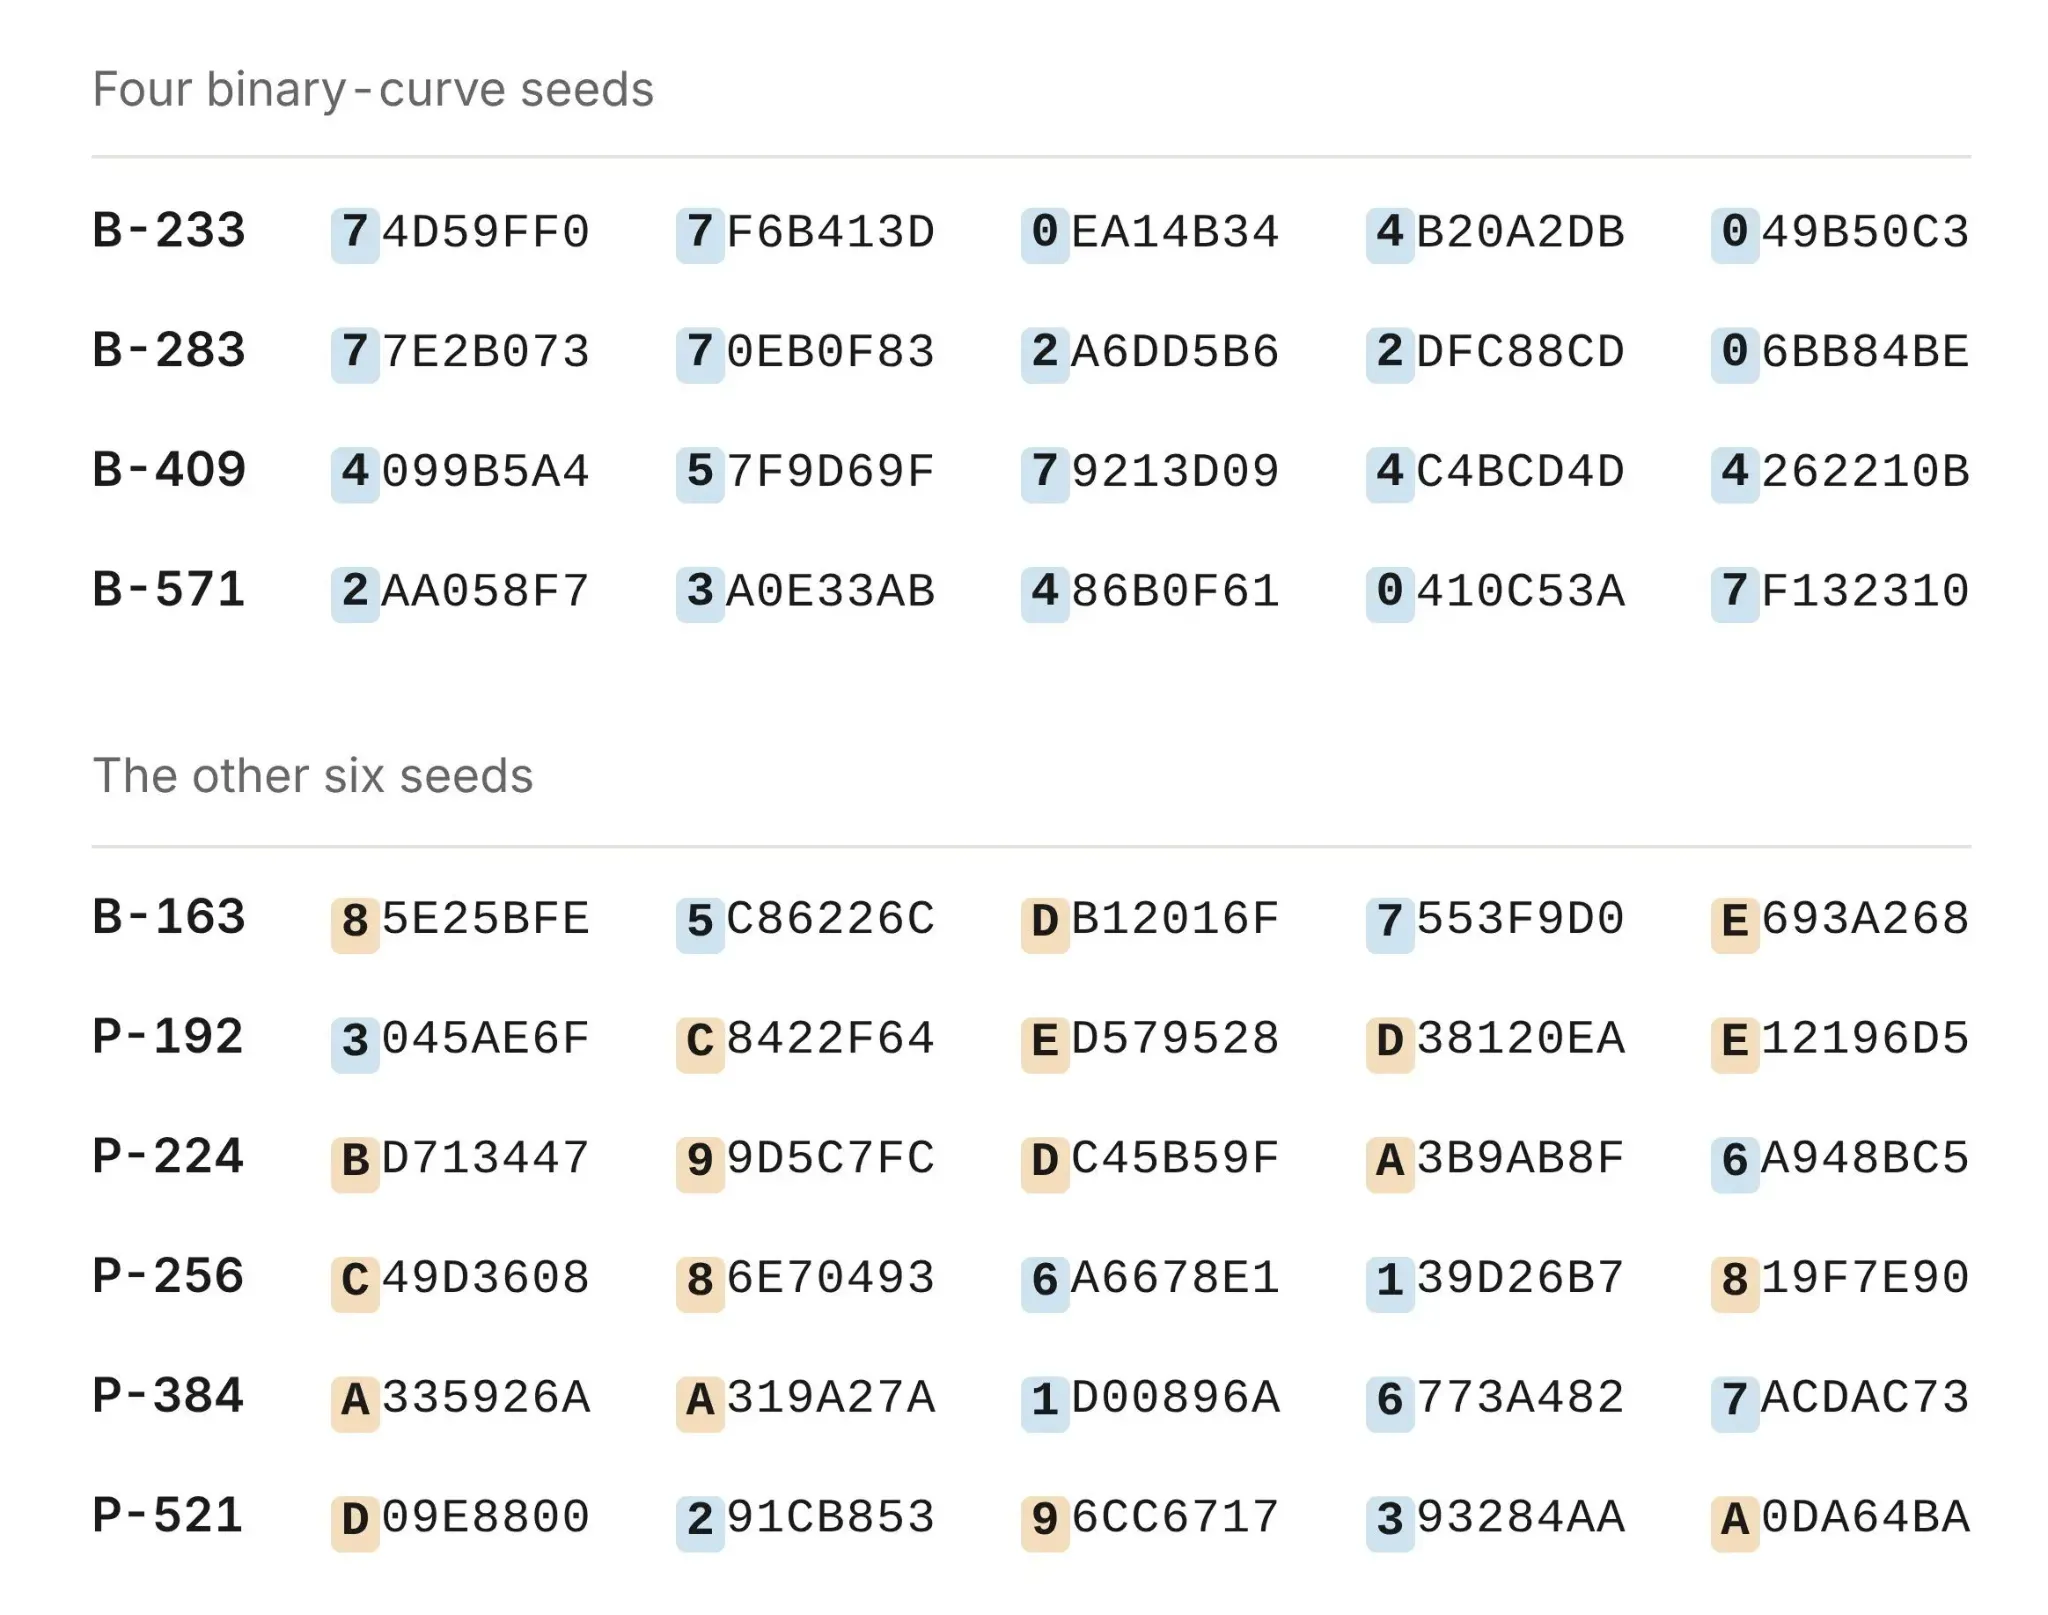
نتایج نشان دادند بذرهای پنج منحنی اصلی NIST و پنج منحنی نمونه دیگر، الگویی مشترک در خروجی مولد lrand48 دارند.
مهمتر اینکه مدل توانست وضعیتهایی را پیدا کند که تمام ۱۶۰ بیت بذرهای منتشرشده را دوباره تولید میکردند.
مرحله بعدی، بازگشت از وضعیت داخلی مولد به مقدار اولیه آن بود.
در اینجا مشخص شد مقداردهی اولیه مولد با برچسبهای زمانی یونیکس انجام شده است.
زمان یونیکس، تعداد ثانیههای سپریشده از ابتدای سال ۱۹۷۰ میلادی را نمایش میدهد. این روش به برنامهها اجازه میدهد زمان را بهشکل یک عدد ذخیره و پردازش کنند.
براساس یافتهها، زمانهای مربوط به بذرهای منحنیهای اصلی به بازهای میان مه ۱۹۹۷ تا آوریل ۱۹۹۸ تعلق داشتند.
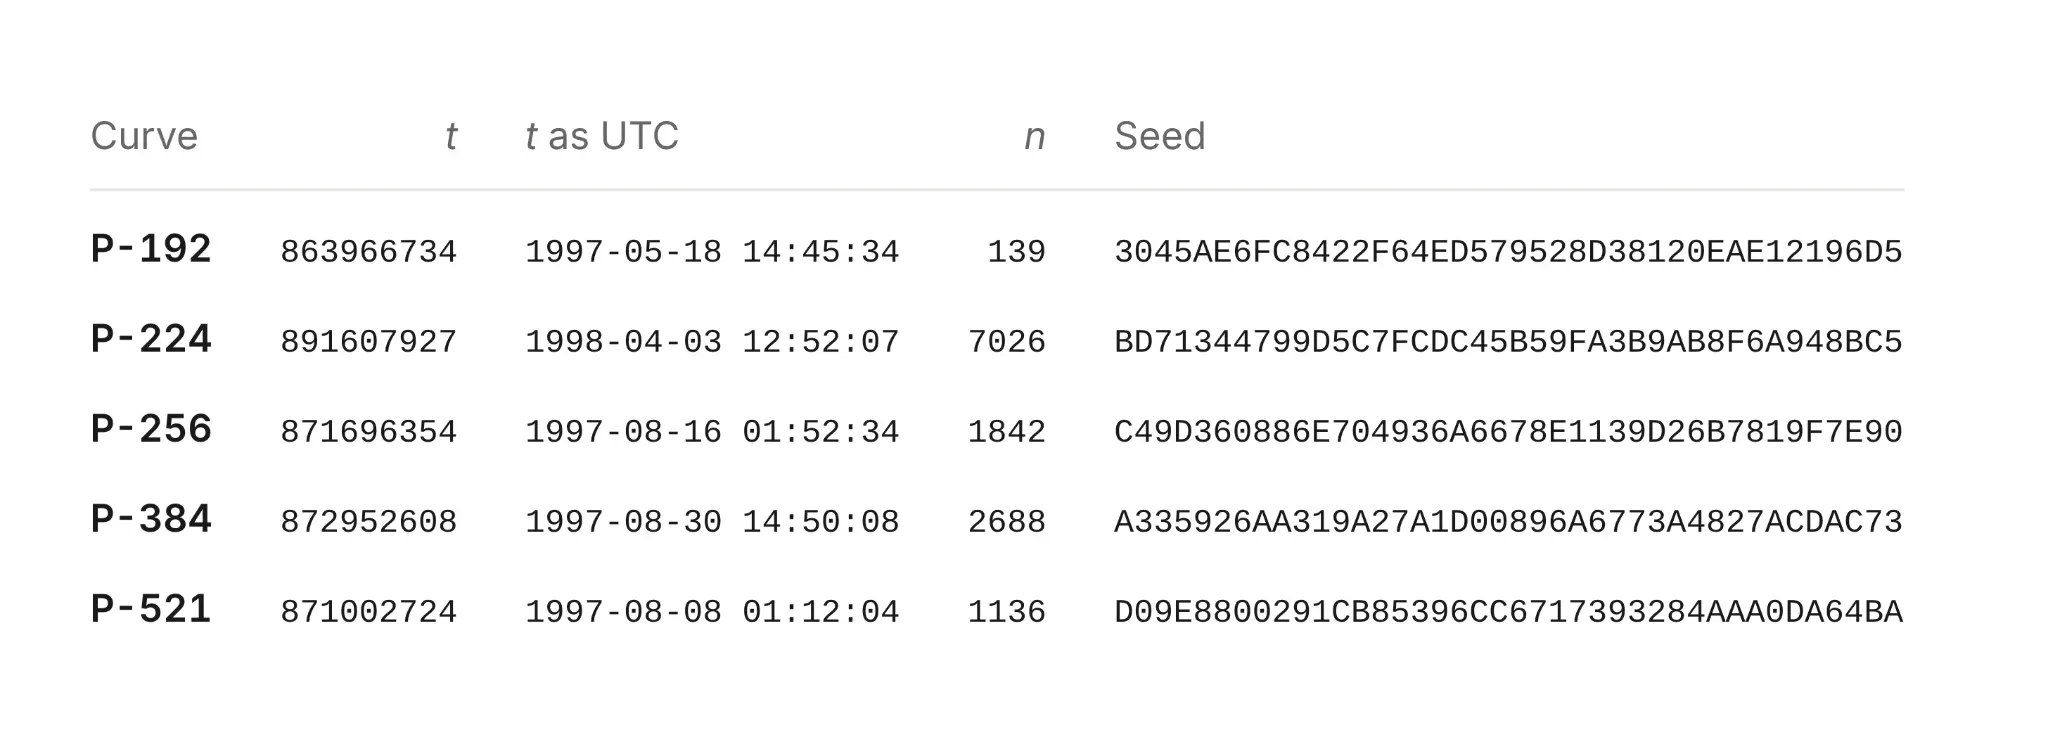
به زبان ساده، سازندگان منحنیها ظاهراً ساعت کامپیوتر را مبنای تولید دنبالهای از اعداد قرار داده بودند و پس از بررسی گزینههای مختلف، مقادیر مناسب را انتخاب کرده بودند.
Claude منشأ کدام منحنیهای رمزنگاری را شناسایی کرد؟
دستاورد اصلی Claude بازسازی منشأ بذرهای پنج منحنی استاندارد NIST بود؛ منحنیهایی که با نامهای P-192، P-224، P-256، P-384 و P-521 شناخته میشوند.
این منحنیها از نظر اندازه پارامترها و سطح امنیت هدف یکسان نیستند، اما همگی در خانواده منحنیهای بیضوی استاندارد قرار میگیرند.
نتیجه بررسیها بهشکل زیر خلاصه میشود:
منحنی رمزنگاری | نتیجه بررسی Claude |
|---|---|
P-192 | بازسازی منشأ بذر استاندارد |
P-224 | بازسازی منشأ بذر استاندارد |
P-256 | شناسایی بذر پس از ۱۸۴۲ گزینه |
P-384 | بازسازی منشأ بذر استاندارد |
P-521 | بازسازی منشأ بذر استاندارد |
برای تولید هر بذر احتمالی، برنامه ۲۰ بایت خروجی از مولد شبهتصادفی دریافت میکرد. سپس گزینههای متوالی بررسی میشدند تا بذر نهایی به دست بیاید.
برای مثال، بذر منحنی P-256 در گزینه شماره ۱۸۴۲ قرار داشت.
اهمیت این نتیجه آن است که روش بازسازی، تنها شباهتی تقریبی میان چند عدد نشان نمیدهد؛ بلکه میتواند بذر منتشرشده را دقیقاً بازتولید کند.
چرا منحنی P-256 اهمیت ویژهای دارد؟
منحنی P-256 از گزینههای شناختهشده در رمزنگاری مبتنی بر منحنی بیضوی است و در پیادهسازیهای مختلف امضای دیجیتال و ارتباطات امن کاربرد دارد.
به همین دلیل، شفافشدن منشأ پارامترهای آن برای متخصصان امنیت موضوع مهمی است.
نکته جالب درباره P-256 این است که مقدار نهایی بذر از سالها پیش مشخص بود. چیزی که پژوهشگران نمیدانستند، مسیر رسیدن به آن عدد بود.
Claude با بازسازی فرایند تولید، نشان داد چگونه میتوان از یک زمان مشخص در سال ۱۹۹۷ و مولد شبهتصادفی قدیمی به همان مقدار نهایی رسید.
بهبیان دیگر، مدل پاسخی قابل بررسی به پرسش «این عدد از کجا آمده است؟» ارائه کرد.
کشف دوم Claude؛ شناسایی منشأ نقاط پایه شش منحنی
نتایج پژوهش به بذرهای منحنیها محدود نماند.
هر منحنی مورد استفاده در ECDSA، افزونبر پارامترهای اصلی، دارای نقطه پایه مشخصی است که معمولاً با حرف G نمایش داده میشود.
این نقطه در محاسبات مربوط به کلید عمومی نقش دارد. برای نمونه، کلید عمومی از ضرب ریاضی کلید خصوصی در نقطه پایه به دست میآید.
نکته اینجاست که دانستن روش تولید بذر لزوماً مشخص نمیکند نقطه پایه چگونه انتخاب شده است.
Claude در ادامه بررسیهای خود، منشأ نقاط پایه شش منحنی را نیز بازسازی کرد.
یکی از آنها P-192 بود و پنج مورد دیگر به منحنیهای نمونه استاندارد ANSI X9.62 تعلق داشتند.
ردپای کتابخانه ریاضی FreeLIP
براساس یافتههای آنتروپیک، نقاط پایه این شش منحنی با استفاده از مولد اعداد موجود در بسته نرمافزاری FreeLIP تولید شده بودند.
این بسته برای محاسبات مربوط به اعداد صحیح بزرگ طراحی شده بود و نسخههای اولیه کتابخانه NTL نیز از کد مشابهی استفاده میکردند.
روش بازسازی چند مرحله داشت: ابتدا مولد با عددی کوچک مقداردهی اولیه میشد، هفت خروجی نخست کنار گذاشته میشد و سپس مقادیر بعدی برای ساخت مختصات احتمالی نقاط به کار میرفتند.
این روند تا رسیدن به نقطهای سازگار با معادله منحنی ادامه پیدا میکرد.
Claude توانست مقادیر اولیه لازم را شناسایی کند و مختصات منتشرشده را بازتولید کند.
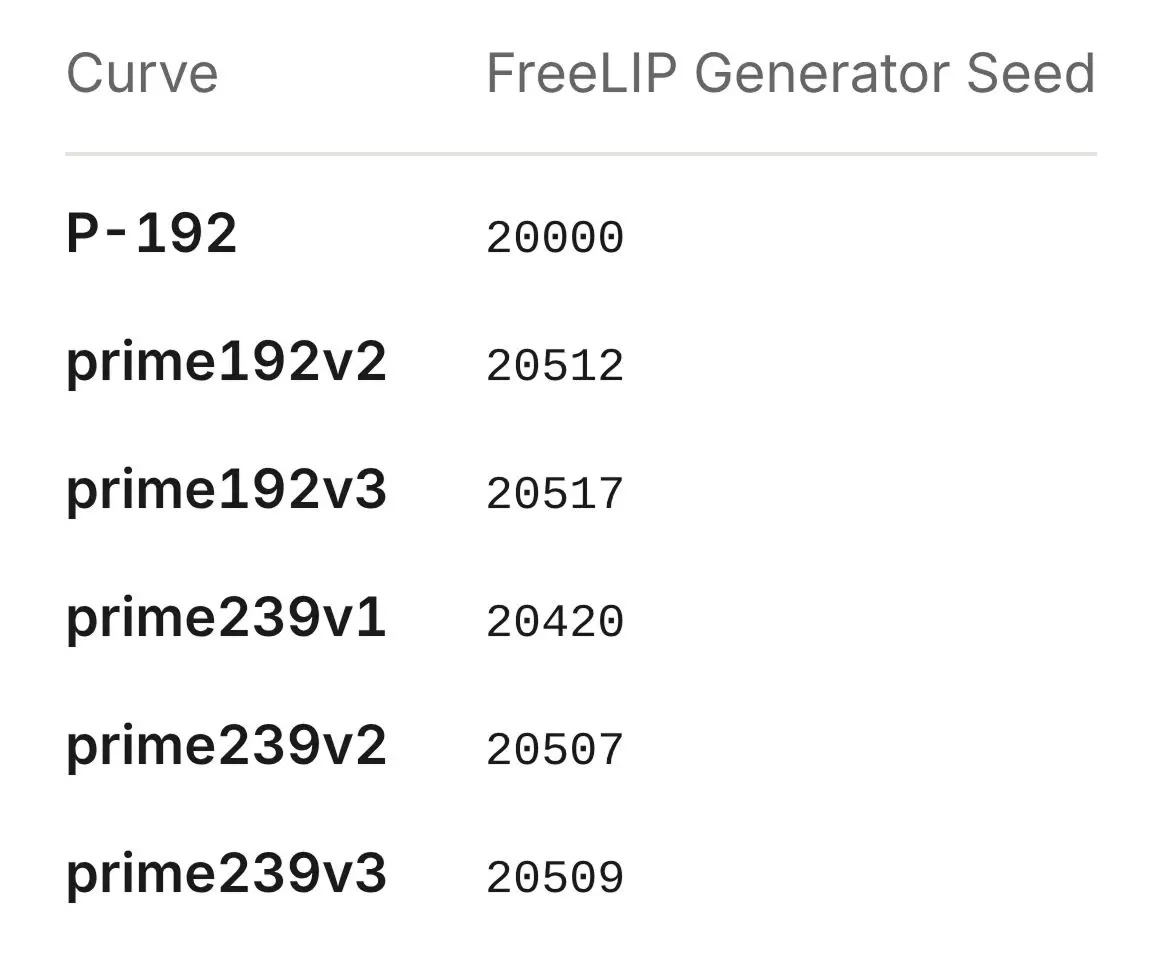
بااینحال، منشأ نقاط پایه چهار منحنی P-224، P-256، P-384 و P-521 هنوز با این روش توضیح داده نشده است.
این موضوع نشان میدهد باوجود پیشرفت مهم پژوهش، تمام بخشهای ناشناخته فرایند طراحی استانداردها روشن نشدهاند.
آیا کشف Claude به معنای شکستهشدن رمزنگاری اینترنت است؟
خیر. کشف Claude نه یک حمله رمزنگاری جدید است و نه نشان میدهد سامانههای مبتنی بر ECDSA آسیبپذیر شدهاند.
آنتروپیک نیز صریحاً تأکید کرده است که کاربران و سازمانها بهدلیل این یافته نیازی به تغییر فوری روشهای رمزنگاری خود ندارند.
آنچه Claude شناسایی کرده، فرایند تولید تعدادی از پارامترهای عمومی استاندارد است، نه کلیدهای خصوصی کاربران.
این تفاوت از نظر امنیتی بسیار مهم است.
چرا کشف بذر منحنی به معنای افشای کلید خصوصی نیست؟
در سامانههای مبتنی بر رمزنگاری کلید عمومی، اطلاعاتی وجود دارند که عمداً برای همه قابل مشاهدهاند. پارامترهای منحنی و نقطه پایه در همین گروه قرار میگیرند.
در مقابل، کلید خصوصی هر کاربر باید محرمانه باقی بماند.
دانستن اینکه یک پارامتر عمومی در دهه ۱۹۹۰ چگونه ساخته شده است، بهخودیخود راهی برای محاسبه کلید خصوصی کاربران فراهم نمیکند.
برای درک تفاوت، میتوان یک بازی فکری را در نظر گرفت: دانستن قواعد بازی و شیوه طراحی صفحه آن، لزوماً باعث نمیشود بتوان حرکتهای محرمانه بازیکن دیگر را پیشبینی کرد.
البته این تشبیه تمام پیچیدگیهای رمزنگاری را توضیح نمیدهد، اما تفاوت میان اطلاعات عمومی استاندارد و دادههای محرمانه کاربران را روشن میکند.
ضعیفبودن مولد شبهتصادفی lrand48 نیز در این ماجرا بهتنهایی نشاندهنده ضعف منحنیهای استاندارد نیست.
اگر از چنین مولدی برای ساخت کلیدهای خصوصی استفاده شود، شرایط کاملاً متفاوت خواهد بود و امکان بروز آسیبپذیری جدی وجود دارد.
اما در این پژوهش، بحث بر سر انتخاب تاریخی پارامترهای عمومی است.
آیا نگرانی درباره درهای پشتی NSA برطرف شده است؟
یافته تازه میتواند بخشی از نگرانیها را کاهش دهد، زیرا نشان میدهد پارامترهای مورد بررسی با روشی نسبتاً ساده و قابل بازتولید تولید شدهاند.
این شفافیت، احتمال انتخاب عمدی اعداد با هدف پنهانکردن ویژگیهای خطرناک را از نگاه پژوهشگران آنتروپیک کمتر میکند.
بااینحال، نباید نتیجه گرفت که اکنون نبود هرگونه ضعف عمدی بهشکل قطعی اثبات شده است.
از سوی دیگر، جنجالهای تاریخی مربوط به الگوریتمهایی مانند Dual_EC_DRBG، موضوعی جداگانه هستند و نباید با منشأ بذرهای ECDSA یکسان در نظر گرفته شوند.
اطلاعات رسمی درباره استانداردهای امضای دیجیتال نیز در مستندات NIST در دسترس است.
چه بخشهایی از معمای رمزنگاری هنوز حل نشدهاند؟
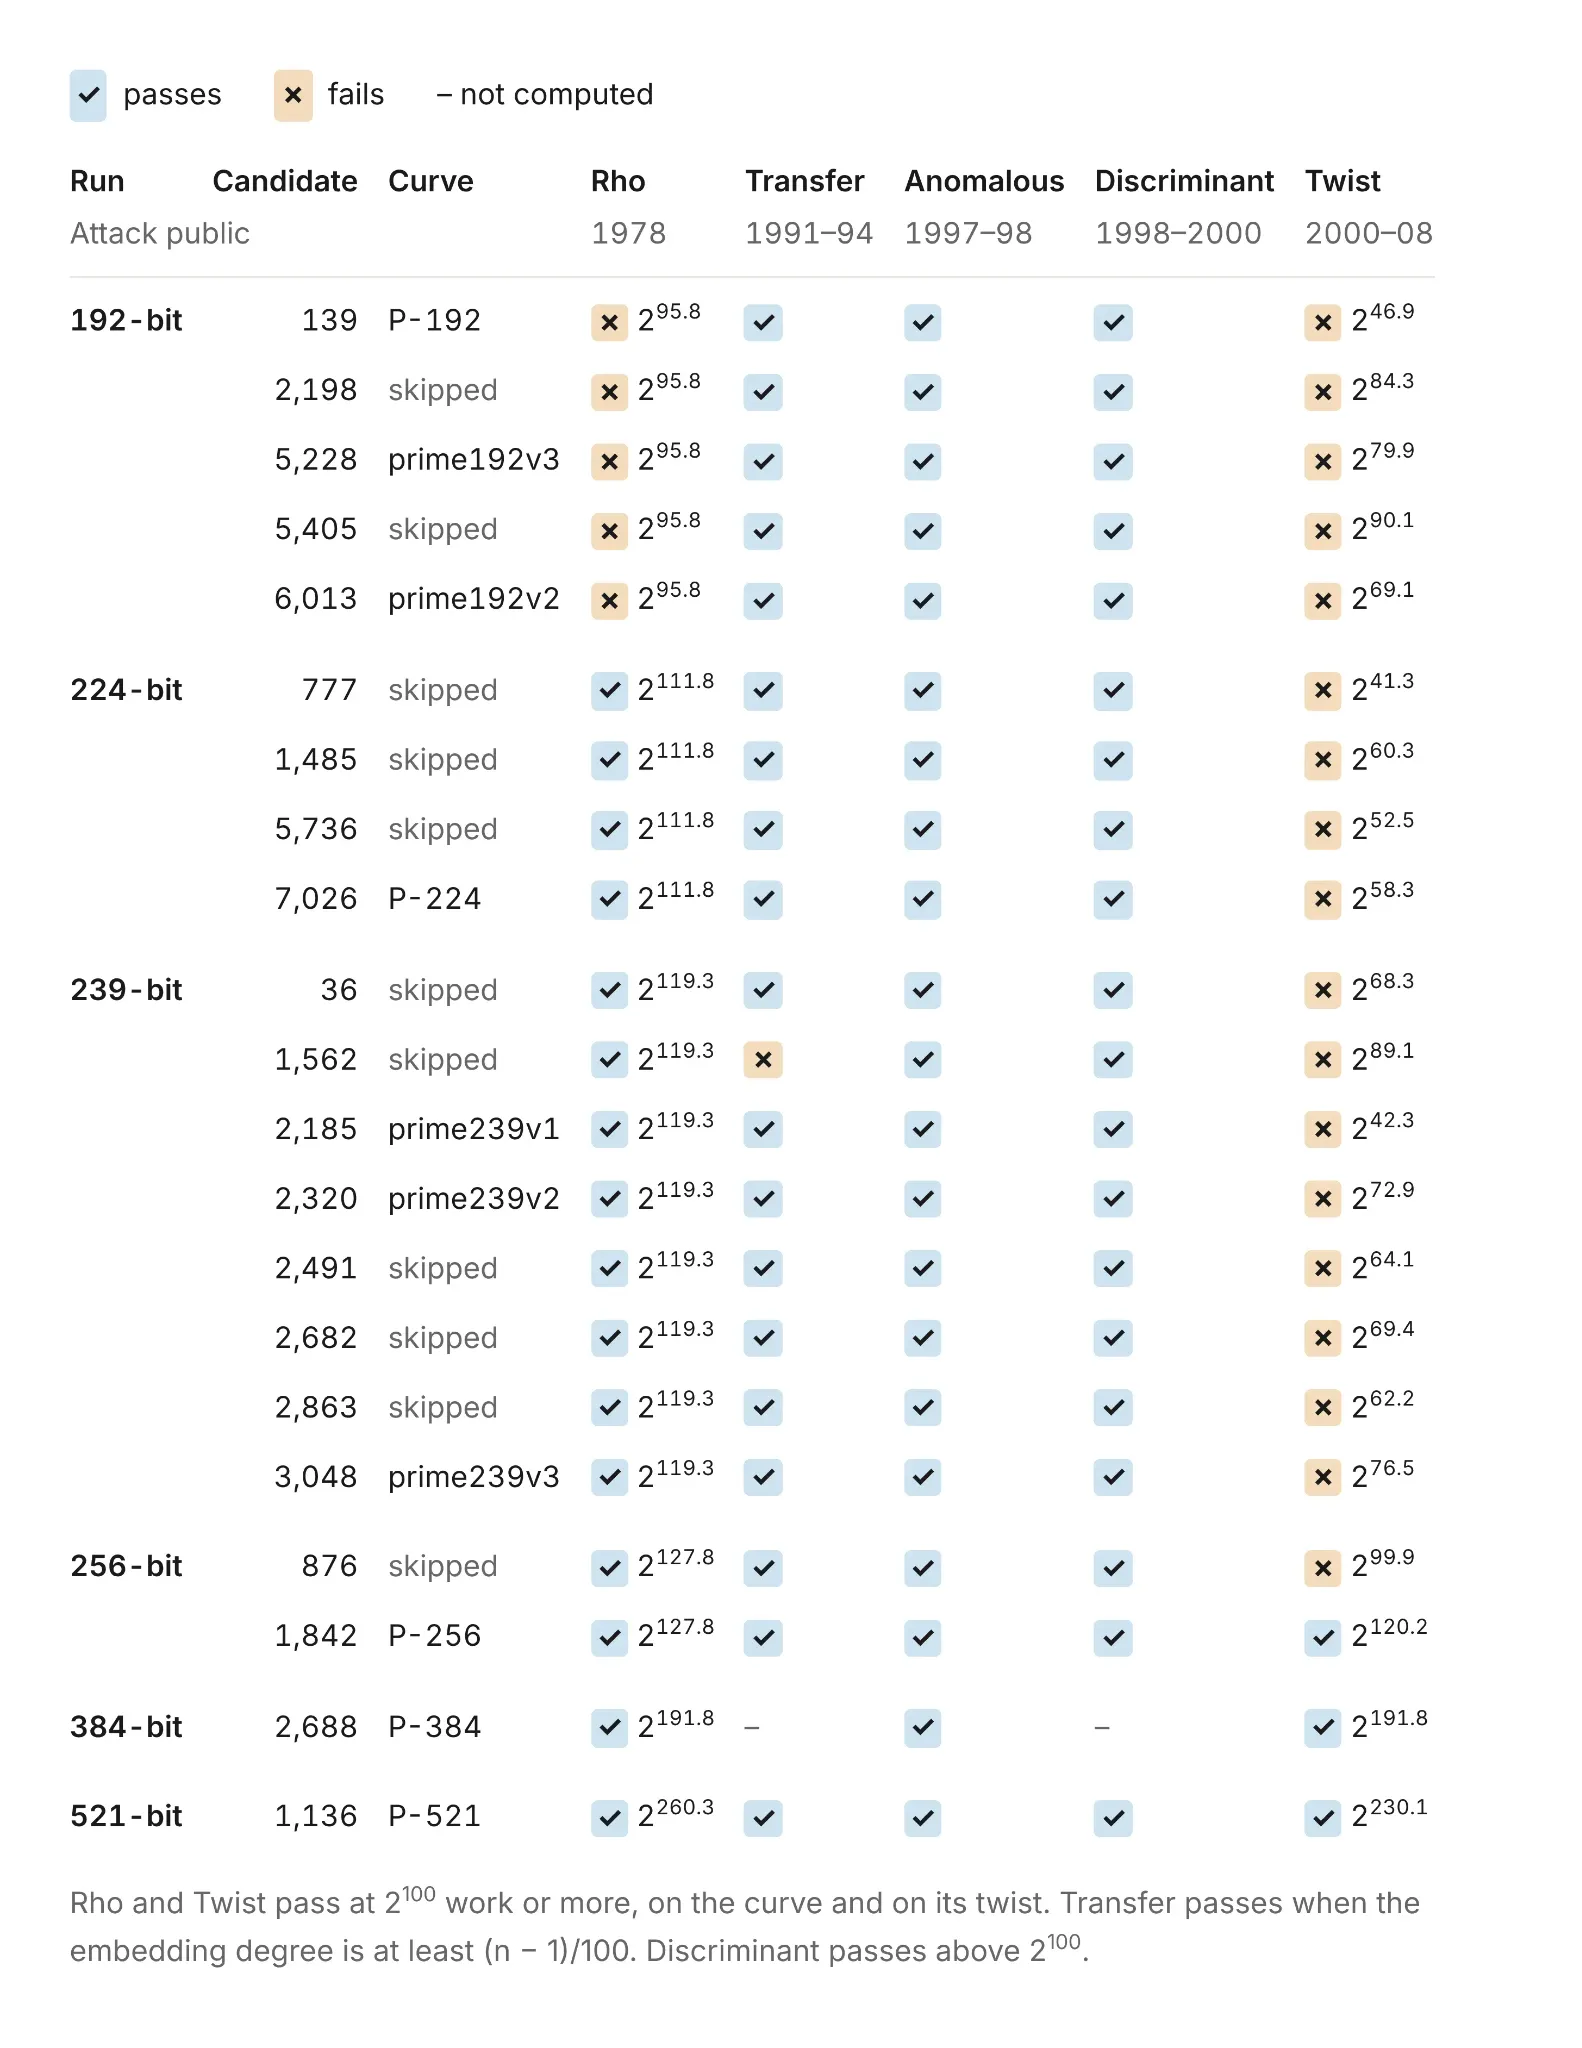
یکی از جالبترین بخشهای پژوهش، شناسایی گزینههایی است که ظاهراً از نظر ریاضی قابل قبول بودهاند، اما در فرایند انتخاب نهایی کنار گذاشته شدهاند.
برای مثال، در روند تولید منحنی P-256، گزینه شماره ۸۷۶ نیز میتوانسته به منحنیای با مرتبه اول و اندازه مناسب منجر شود. بااینحال، بذر نهایی از گزینه شماره ۱۸۴۲ انتخاب شده است.
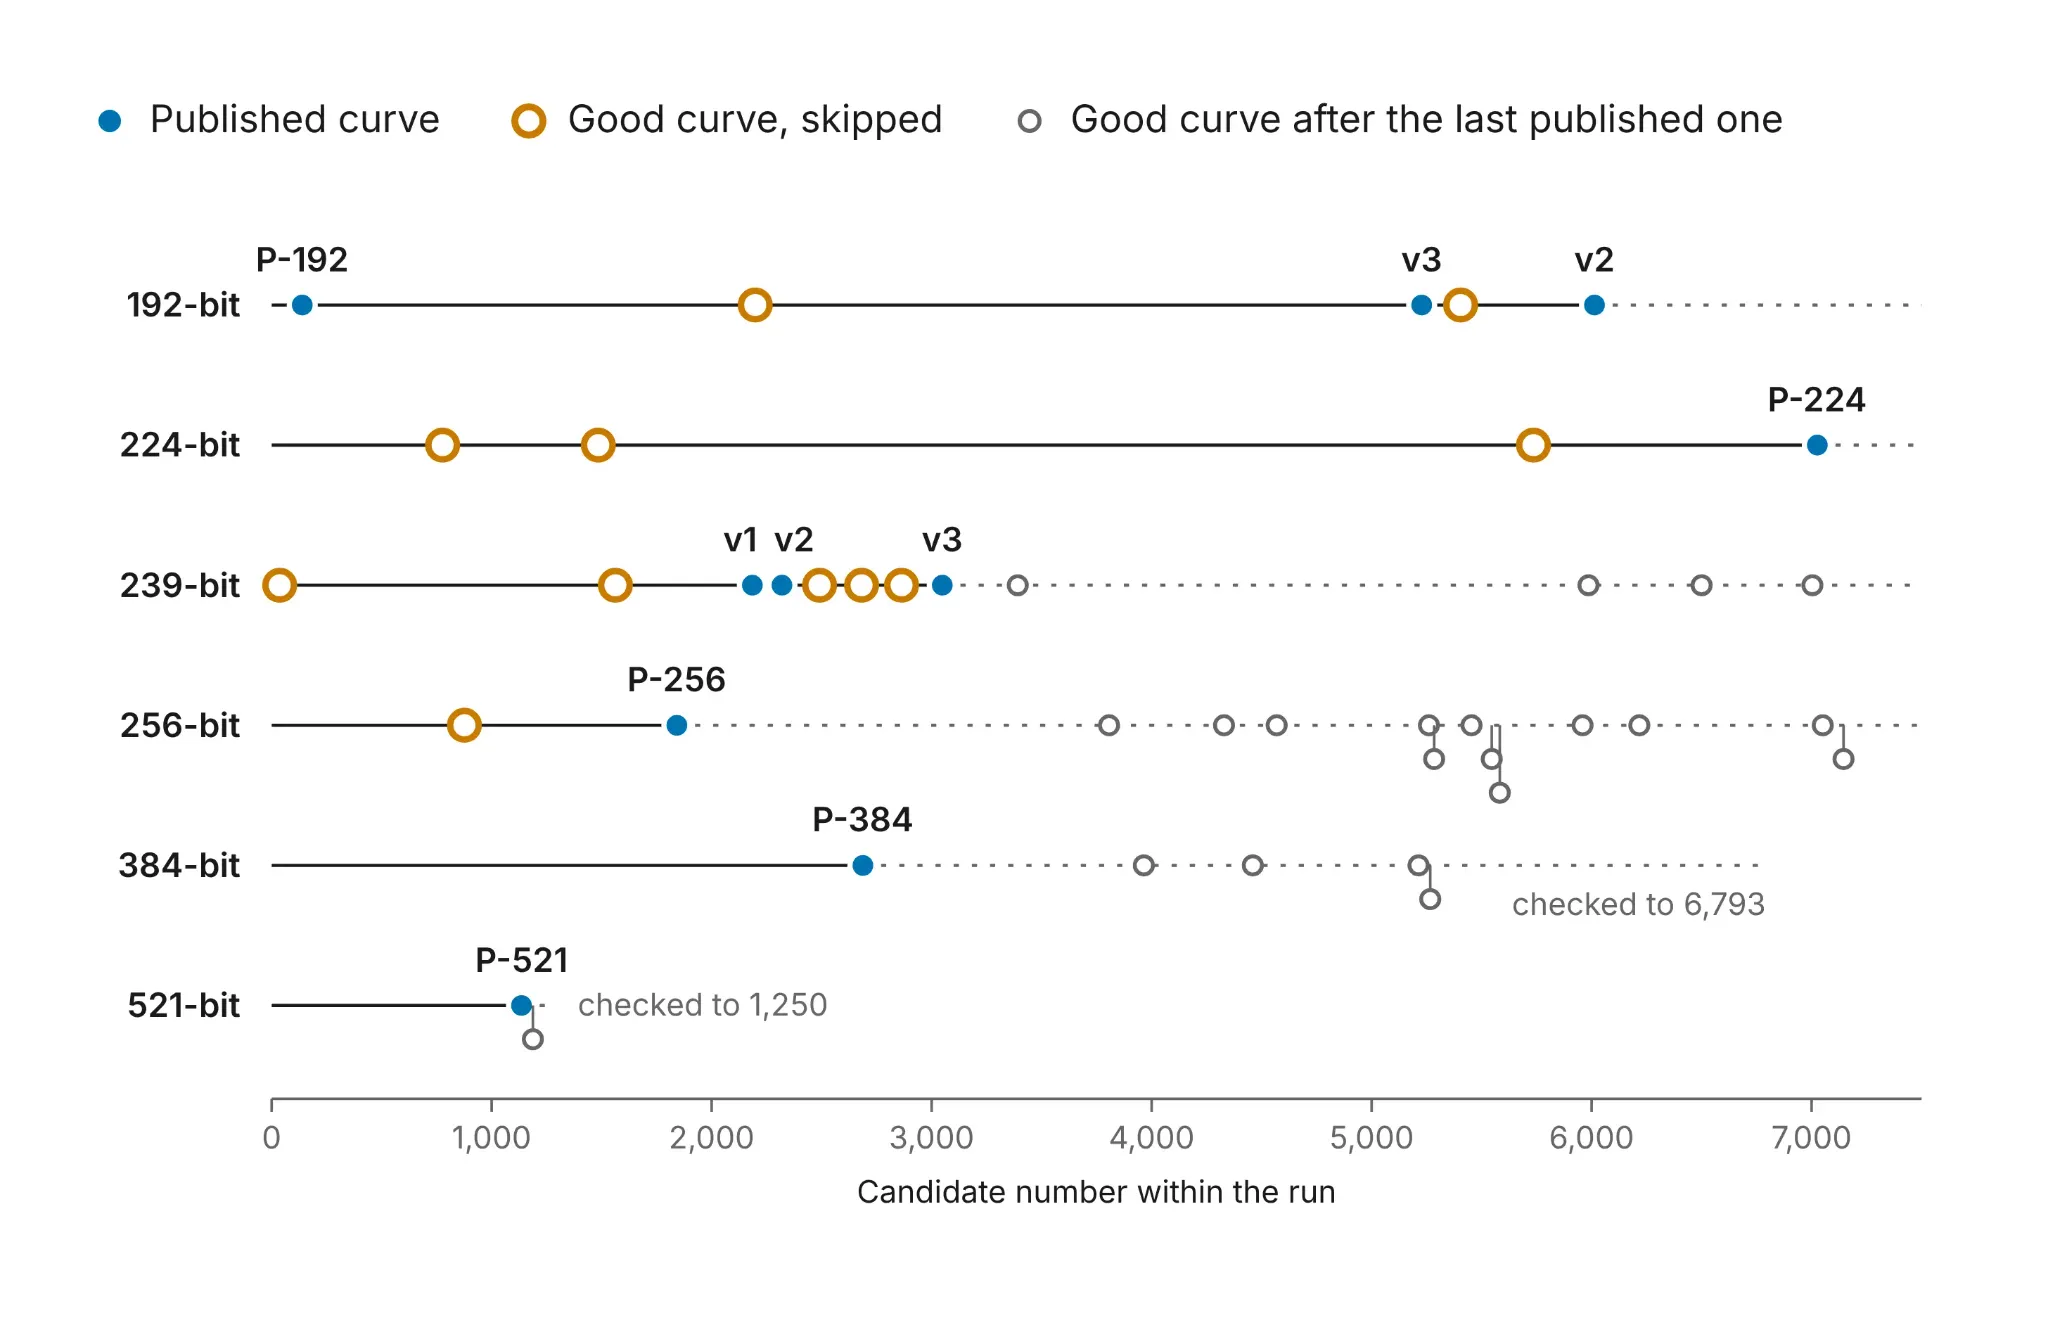
پژوهشگران هنوز نمیدانند چه معیارهایی باعث کنارگذاشتن گزینههای قبلی شدهاند.
در بررسی P-224 نیز سه گزینه قابل قبول کنار گذاشته شده بودند. در مجموعهای از منحنیهای نمونه ANSI X9.62 نیز موارد مشابهی مشاهده شد.
آنتروپیک معتقد است تعداد محدود این گزینهها، فرضیه جستوجوی عمدی برای پیدا کردن منحنیهای ضعیف را چندان محتمل نمیکند؛ اما دلیل دقیق حذف آنها همچنان روشن نیست.
ابهام دیگر به منحنی B-163 مربوط میشود. Claude نتوانسته است منشأ بذر این منحنی را با روشهای آزمایششده شناسایی کند.
روش تولید نقاط پایه چند منحنی دیگر نیز هنوز توضیح کاملی ندارد.
بنابراین، پژوهش تازه بخش قابلتوجهی از یک مسئله تاریخی را حل کرده است، اما به معنای بستهشدن تمام پرسشهای علمی مربوط به این استانداردها نیست.
چرا این دستاورد برای آینده پژوهش با هوش مصنوعی مهم است؟
شاید جذابترین بخش این خبر، مدتزمان کوتاهی باشد که Claude برای رسیدن به پاسخ نیاز داشته است؛ اما اهمیت واقعی پژوهش فراتر از سرعت بالای مدل است.
در این ماجرا، هوش مصنوعی صرفاً اطلاعات موجود را خلاصه نکرد. مسئلهای فنی را بررسی کرد، فرضیه ساخت، برنامه نوشت، محاسبات انجام داد و نتایج را با مقادیر منتشرشده مقایسه کرد.
چنین فرایندی نمونهای از استفاده از مدلهای هوش مصنوعی برای حل مسئله و کمک به پژوهش محاسباتی است.
تفاوت پاسخدادن با کشف یک نتیجه قابل بازتولید
مدلهای زبانی میتوانند درباره موضوعات پیچیده توضیحات قانعکنندهای ارائه دهند، اما قانعکنندهبودن یک پاسخ، به معنای درستبودن آن نیست.
در این پژوهش، ارزش یافتهها به امکان بررسی مستقل آنها وابسته است.
آنتروپیک کدهای لازم برای بازسازی بذرها و بعضی از نقاط پایه را نیز در گزارش خود منتشر کرده است.
در نتیجه، پژوهشگران میتوانند محاسبات را اجرا کنند و بررسی کنند آیا به همان نتایج میرسند یا خیر.
این ویژگی در پژوهش علمی اهمیت فراوانی دارد. وقتی یک یافته فقط به توضیح متنی محدود نباشد و با شواهد محاسباتی همراه شود، امکان ارزیابی دقیقتر آن فراهم خواهد شد.
آیا هوش مصنوعی میتواند جای پژوهشگران انسانی را بگیرد؟
موفقیت Claude نشان میدهد مدلهای پیشرفته میتوانند در برخی مسائل ریاضی و برنامهنویسی، ابزارهایی بسیار توانمند باشند؛ اما نباید آن را به تمام حوزههای پژوهشی تعمیم داد.
در این پروژه، مسئله از سوی انسان مطرح شد و بررسی اهمیت امنیتی یافتهها نیز به دانش تخصصی وابسته بود.
مدل توانست مسیر حل را کوتاهتر کند، اما تشخیص پیامدهای واقعی آن همچنان نیازمند تحلیل متخصصان است.
به همین دلیل، یکی از مهارتهای مهم در استفاده حرفهای از هوش مصنوعی، فقط نوشتن دستور برای مدل نیست؛ بلکه توانایی تعریف مسئله، ارزیابی خروجی و بررسی اعتبار پاسخها نیز اهمیت دارد.
این موضوع در یادگیری کاربردی هوش مصنوعی نیز اهمیت ویژهای دارد؛ زیرا ارزش واقعی ابزارهای هوشمند زمانی آشکار میشود که کاربران بتوانند از آنها برای انجام کارهای مشخص و قابل ارزیابی استفاده کنند.
سرنوشت جایزه ۳۶ هزار دلاری معمای رمزنگاری چه شد؟
برای شناسایی منشأ بذرهای منحنیهای استاندارد، جایزهای به ارزش ۳۶ هزار و ۸۶۴ دلار در نظر گرفته شده بود.
طبق اعلام آنتروپیک، این مبلغ به گروه پژوهشی امنیت اینترنت (Internet Security Research Group) اهدا خواهد شد؛ سازمانی که در توسعه زیرساختهای امنیتی اینترنت فعالیت میکند.
وجود چنین جایزهای نشان میدهد منشأ این پارامترها برای مدت طولانی مسئلهای جدی و شناختهشده در جامعه رمزنگاری بوده است.
بااینحال، ارزش این کشف را نمیتوان تنها با مبلغ جایزه سنجید. مهمترین نتیجه آن، روشنشدن بخشی از تاریخ استانداردهایی است که سالها درباره فرایند انتخاب پارامترهایشان پرسش وجود داشت.
جمعبندی؛ Claude چه چیزی را تغییر داد؟
کشف تازه Claude نشان داد منشأ بذر پنج منحنی مهم رمزنگاری NIST را میتوان با بررسی یک مولد شبهتصادفی قدیمی و زمانهای ثبتشده در دهه ۱۹۹۰ بازسازی کرد.
این نتیجه از یکسو بخشی از ابهامهای تاریخی درباره طراحی استانداردهای ECDSA را کاهش میدهد و از سوی دیگر، نمونهای جالب از توانایی هوش مصنوعی در پژوهشهای محاسباتی به شمار میرود.
بااینحال، برخی پرسشها درباره انتخاب پارامترها و نقاط پایه همچنان بیپاسخ ماندهاند. مهمتر اینکه هیچ مدرکی مبنی بر شکستهشدن ECDSA یا ضرورت تغییر فوری سامانههای موجود در این پژوهش ارائه نشده است.
ماجرای Claude یادآوری میکند که کاربرد هوش مصنوعی به تولید متن و پاسخدادن به پرسشهای روزمره محدود نیست. این فناوری میتواند در کنار دانش انسانی، به بررسی مسائل پیچیده، آزمایش فرضیهها و کشف روابطی کمک کند که پیشتر یافتن آنها زمان زیادی میبرد.
برای مطالعه تحلیلهای بیشتر درباره کاربردهای واقعی هوش مصنوعی و پیشرفت مدلهای پیشرفته، میتوانید بخش مقالات آکادمی هوش مصنوعی ایران را دنبال کنید.
سوالات متداول
آیا Claude توانسته الگوریتم رمزنگاری ECDSA را بشکند؟
خیر. Claude منشأ پارامترهای عمومی چند منحنی استاندارد NIST را بازسازی کرده است. این کشف به معنای شکستن ECDSA، افشای کلیدهای خصوصی یا پیدا شدن یک حمله جدید نیست.
Claude چگونه معمای ۲۵ ساله رمزنگاری را حل کرد؟
Claude با بررسی الگوهای عددی و بازسازی عملکرد مولد شبهتصادفی lrand48 نشان داد بذرهای چند منحنی استاندارد با استفاده از برچسبهای زمانی یونیکس در دهه ۱۹۹۰ تولید شدهاند.
Claude منشأ کدام منحنیهای رمزنگاری را پیدا کرد؟
این مدل منشأ بذرهای پنج منحنی P-192، P-224، P-256، P-384 و P-521 را بازسازی کرده و روش تولید نقاط پایه شش منحنی مرتبط را نیز شناسایی کرده است.
آیا کاربران باید پس از کشف Claude تنظیمات امنیتی خود را تغییر دهند؟
براساس اعلام آنتروپیک، این پژوهش بهخودیخود ضرورتی برای تغییر فوری سامانههای مبتنی بر منحنیهای مورد بررسی ایجاد نمیکند.
آیا تمام ابهامهای مربوط به استانداردهای رمزنگاری NIST برطرف شدهاند؟
خیر. منشأ برخی بذرها و نقاط پایه، از جمله بذر B-163 و روش تولید نقاط پایه چند منحنی دیگر، همچنان بهطور کامل مشخص نشده است.
نظرات (۰)
هنوز نظری ثبت نشده است. اولین نفر باشید.