فهرست مطالب
- مدل تصمیمگیر چیست و چه فرقی با LLM دارد؟
- Jev؛ مدلی که این موج را راه انداخت
- Clef؛ مدل تصمیمگیر متنباز Cloudflare
- Strands Decider 2B؛ مدل کوچک AWS برای اجرای محلی
- چطور ساخته شده؟
- عملکرد
- مقایسه Clef، Strands Decider 2B و Jev
- چرا مدلهای تصمیمگیر برای عاملهای هوش مصنوعی مهماند؟
- برای شروع چه کنیم؟
- جمعبندی
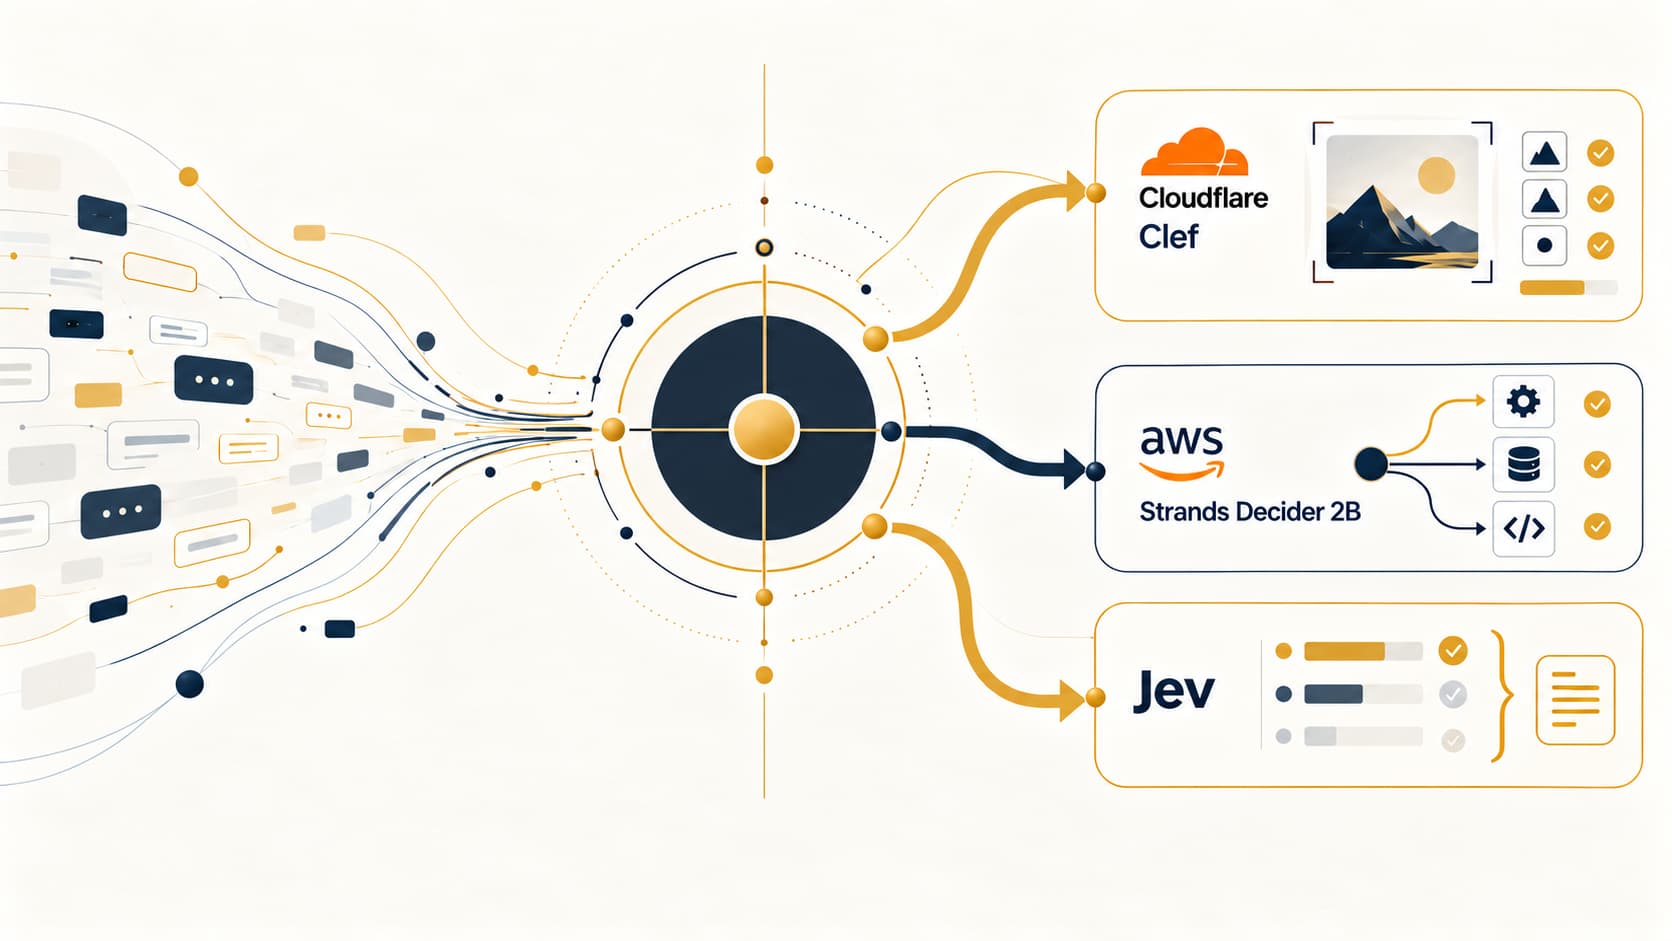
مدل تصمیمگیر (Decision Model) نوع تازهای از مدلهای هوش مصنوعی است که متن تولید نمیکند. فقط از میان گزینههایی که شما تعیین کردهاید یکی را انتخاب میکند، به چیزی امتیاز میدهد یا به یک سؤال بله/خیر جواب میدهد و کنار هر پاسخ یک عدد اطمینان هم برمیگرداند. این ایده با معرفی Jev از استارتاپ TypeSafe AI در اواسط سپتامبر سر زبانها افتاد. حالا در ۱ اکتبر ۲۰۲۶ (۹ مهر ۱۴۰۵) دو شرکت بزرگ هم وارد این میدان شدهاند: Cloudflare با خانوادهی Clef و AWS با Strands Decider 2B. هر دو متنباز و با مجوز Apache 2.0 منتشر شدهاند.
در این مقاله توضیح میدهیم مدل تصمیمگیر دقیقاً چه کاری میکند، چه فرقی با مدلهای زبانی بزرگ (LLM) دارد، سه مدل مطرح این حوزه را با هم مقایسه میکنیم و میگوییم چرا این موضوع برای کسانی که عامل هوش مصنوعی (AI Agent) میسازند مهم است.
مدل تصمیمگیر چیست و چه فرقی با LLM دارد؟
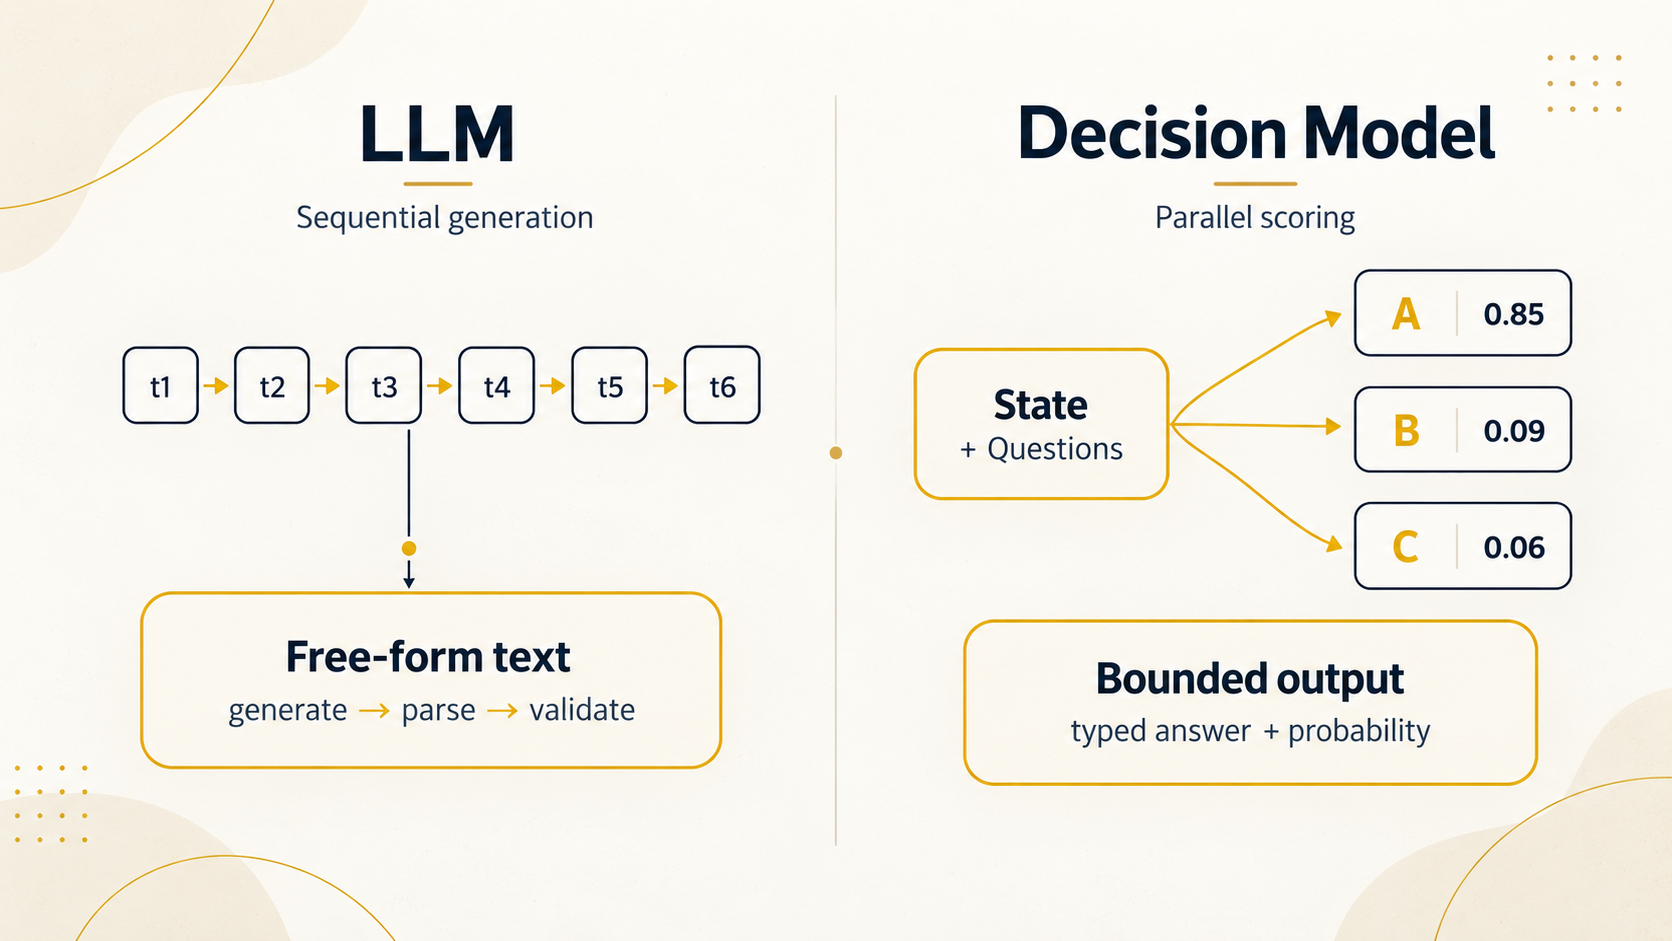
مدلهای زبانی بزرگ پاسخ را توکنبهتوکن تولید میکنند. این روش برای نوشتن، کدنویسی و استدلال عالی است، ولی برای یک تصمیم ساده مثل «این تیکت پشتیبانی فوری است یا نه؟» هم کند است و هم پرهزینه. خروجیاش هم متن آزاد است که باید پردازش شود و گاهی قالب درستی ندارد.
مدل تصمیمگیر این کار را برعکس انجام میدهد. یک «وضعیت» (متن یا دادهی ساختاریافته) و چند سؤال تایپشده دریافت میکند و همهی سؤالها را در یک گذر موازی جواب میدهد. TypeSafe سه نوع سؤال اصلی تعریف کرده است:
Choice: انتخاب یک گزینه از یک فهرست، مثلاً «این درخواست به کدام تیم مربوط است؟ مالی، فنی یا فروش».
Score: امتیازدهی روی یک مقیاس، مثلاً شدت مشکل از «بیاثر» تا «بحرانی».
Noul: سؤال بله/خیر.
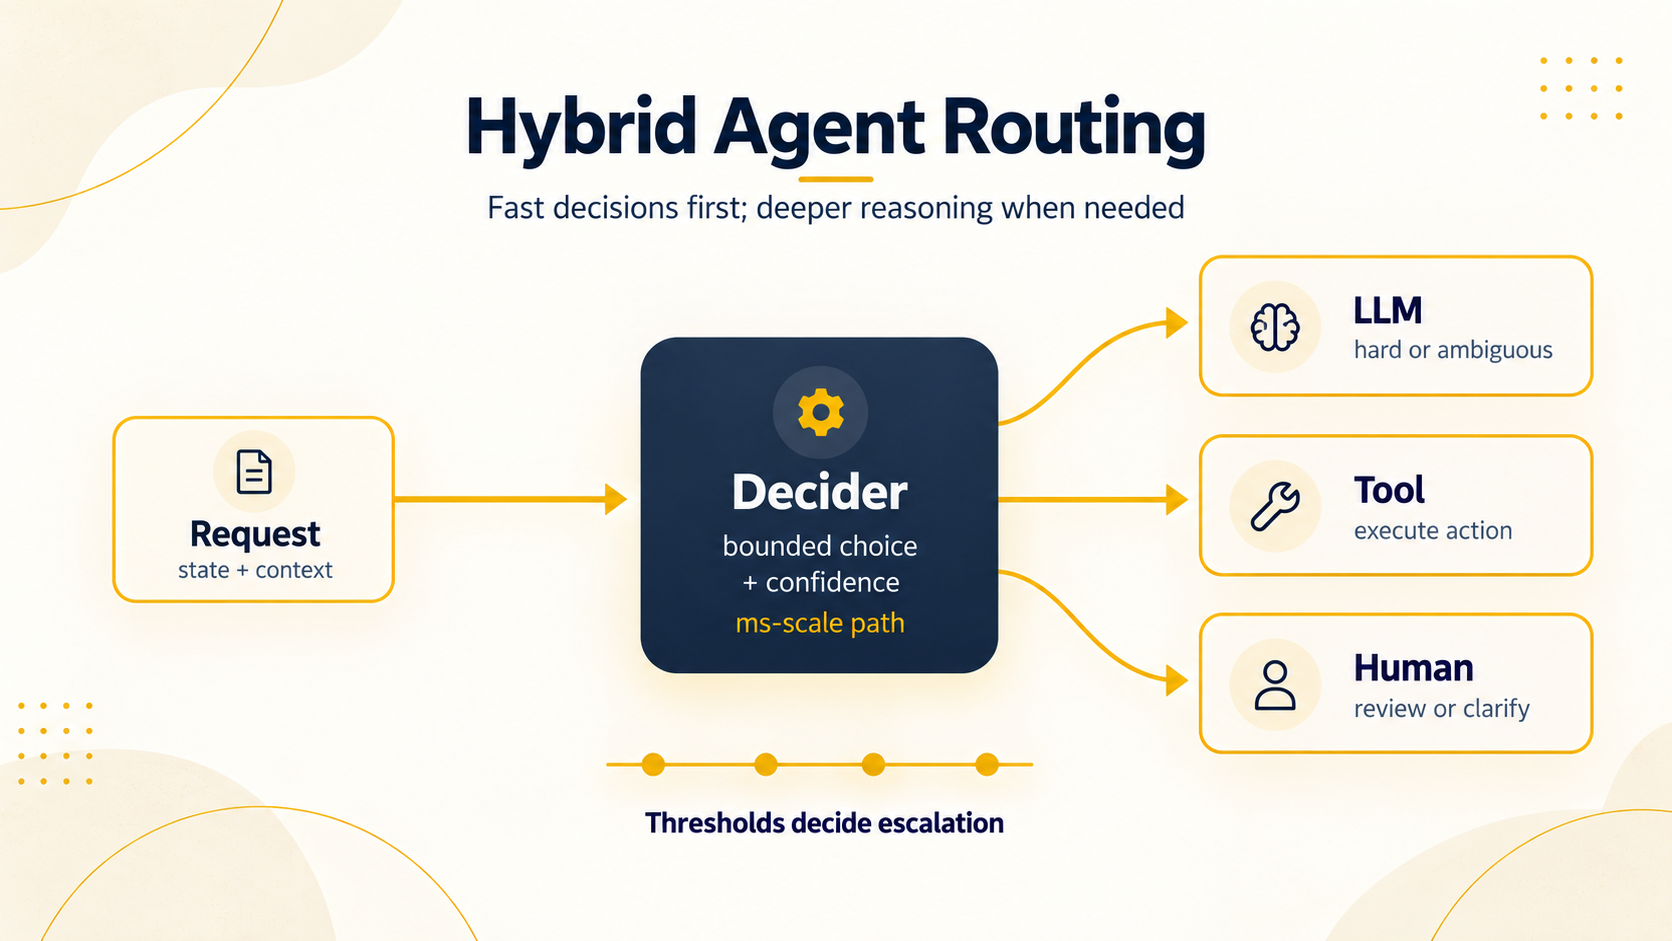
خروجی همیشه یکی از گزینههای مجاز است، همراه با توزیع احتمال. پس کد شما میتواند تصمیم بگیرد که اگر اطمینان از یک آستانه بالاتر بود کار را خودکار انجام دهد و اگر نبود، آن را به یک انسان یا یک مدل بزرگتر بسپارد. TypeSafe این دسته را System One Models مینامد. این نام از کتاب «تفکر، سریع و کند» دنیل کانمن گرفته شده؛
سیستم ۱ همان تفکر سریع و شهودی است و سیستم ۲ تفکر آهسته و سنجیده.
این مدلها محدودیت هم دارند. AWS در معرفی مدل خود صریحاً گفته که چون همهی خروجیها در یک گذر تولید میشوند، این مدلها در حل مسائل پیچید خیلی ضعیفتر از مدلهای استدلالیاند. توانایی تولید متن هم ندارند، پس به درد چتبات، کدنویسی یا خلاصهسازی نمیخورند. TypeSafe هم در مستندات Jev هشدار داده که این مدل در شمارش، محاسبات و مقایسهی تاریخها قابلاعتماد نیست و بهتر است این کارها در کد انجام شوند.
Jev؛ مدلی که این موج را راه انداخت
شرکت TypeSafe AI در ۱۵ سپتامبر ۲۰۲۶ همراه با اعلام جذب ۴۰ میلیون دلار سرمایهی اولیه به رهبری DCVC، مدل Jev را در قالب دسترسی زودهنگام معرفی کرد. بنیانگذار این شرکت، دیوگو آلمیدا، پیشتر در OpenAI روی RLHF و InstructGPT کار کرده است. طبق گزارش InfoQ، پنجرهی زمینهی Jev برابر ۳۲ هزار توکن است، هزینهی ورودی ۰٫۰۴۲ دلار برای هر میلیون توکن است و خروجی رایگان است. تأخیر سرتاسری آن هم بین ۷۰ تا ۵۰۰ میلیثانیه اعلام شده است. روش آموزش Jev «یادگیری تقویتی برای تصمیمهای کالیبرهشده» (RLCD) نام دارد. Jev مدلی اختصاصی (غیرمتنباز) است.
Clef؛ مدل تصمیمگیر متنباز Cloudflare
Cloudflare در ۱ اکتبر دو مدل Clef و Clef-flash را روی Workers AI عرضه کرد و وزنهایشان را هم در Hugging Face گذاشت. به گفتهی خود Cloudflare، این مدلها با API مدل Jev سازگارند، پس جایگزینکردنشان ساده است. ویژگیهای مهمشان:
ورودی تصویری: Clef رمزگذار بینایی دارد و میتواند محتوای تصویری را هم دستهبندی کند. Jev فعلاً فقط متن را پشتیبانی میکند.
پنجرهی زمینهی ۶۴ هزار توکنی، دو برابر Jev.
معماری: Clef روی Qwen3.8-27B و Clef-flash روی Qwen3.5-9B ساخته شدهاند. مدل پایه منجمد شده و یک «سر مسیریابی» همراه با آداپتورهای LoRA روی آن آموزش دیده است. گام تصمیم غیرخودبازگشتی است، یعنی هیچ متن میانیای تولید نمیشود.
سرعت: در آزمونهای خود Cloudflare، میانهی تأخیر Clef حدود ۲۰۹ میلیثانیه، Clef-flash حدود ۳۹ میلیثانیه و Jev حدود ۵۲۴ میلیثانیه بوده است.
Cloudflare یک نمونهی واقعی هم آورده است. تیم هوش تهدید این شرکت از Clef برای دستهبندی دامنههای وب استفاده میکند. فرایند دریافت، رندر و دستهبندی یک وبسایت با Clef حدود ۲٫۲ ثانیه طول کشیده، در حالی که سریعترین LLM عمومی آنها (gpt-oss-120b) در همان گردشکار ۴٫۷ ثانیه زمان برده است. Cloudflare همچنین یک سرویس تنظیم دقیق (fine-tuning) مبتنی بر یادگیری تقویتی معرفی کرده که فعلاً با همراهی مستقیم تیم مهندسیاش ارائه میشود و قرار است بعداً بهصورت سلفسرویس هم در دسترس باشد.
نکته: همهی این بنچمارکها را خود Cloudflare منتشر کرده است. نتایج هم یکدست نیستند؛ مثلاً در آزمون When2Call، مدل Jev امتیاز بالاتری از Clef گرفته است.
Strands Decider 2B؛ مدل کوچک AWS برای اجرای محلی
AWS در همان روز و از طریق پروژهی آزمایشی Strands Labs مدل Strands Decider 2B را منتشر کرد. تمرکز این مدل روی آزمایش سریع و اجرای محلی روی CPU یا GPU معمولی است.
چطور ساخته شده؟
AWS بدنهی پیشآموزشدیدهی Qwen3.5-2B را برداشته و «سر زبانی» آن را حذف کرده است. به همین دلیل این مدل حتی یک کلمه هم نمیتواند تولید کند. بهجای آن یک «سر اشارهگر» (pointer head) با کمی بیش از یک میلیون پارامتر گذاشته که به هر گزینه امتیاز میدهد. بدنه هم با یک آداپتور LoRA رتبهی ۱۶ تنظیم شده است. نسخهای که منتشر شده v19 است و کد، وزنها و حتی دادهها و اسکریپتهای آموزش همگی در دسترساند.
عملکرد
به گفتهی AWS، میانهی تأخیر این مدل روی کارت گرافیک RTX 3090 حدود ۱۱۵ میلیثانیه و روی MacBook با تراشهی M3 برای کارهای کوچک حدود ۱۵۳ میلیثانیه است. در مجموعهی عمومی JevBench هم از نظر دقت و کالیبراسیون، در میان ۳۳ مدل همردهی ۲ میلیارد پارامتری رتبهی سوم را گرفته و همهی وظایف آسان این بنچمارک را درست پاسخ داده است.
مقایسه Clef، Strands Decider 2B و Jev
ویژگی | Jev | Clef / Clef-flash | Strands Decider 2B |
|---|---|---|---|
سازنده | TypeSafe AI | Cloudflare | AWS (Strands Labs) |
تاریخ عرضه | ۱۵ سپتامبر ۲۰۲۶ | ۱ اکتبر ۲۰۲۶ | ۱ اکتبر ۲۰۲۶ |
مجوز | اختصاصی | Apache 2.0 | Apache 2.0 |
نحوهی دسترسی | API (دسترسی زودهنگام) | Workers AI و Hugging Face | دانلود و اجرای محلی (GitHub و Hugging Face) |
مدل پایه | معماری اختصاصی | Qwen3.8-27B / Qwen3.5-9B | Qwen3.5-2B |
پنجرهی زمینه | ۳۲ هزار توکن | ۶۴ هزار توکن | اعلام نشده |
ورودی تصویر | خیر | بله | اعلام نشده |
تأخیر اعلامشده | ۷۰ تا ۵۰۰ میلیثانیه | میانه ~۲۰۹ / ~۳۹ میلیثانیه | میانه ~۱۱۵ میلیثانیه (RTX 3090) |
نقطهی قوت | پیشگام این دسته، اکوسیستم در حال رشد | سرعت روی لبهی شبکه، تصویر، fine-tuning | سبک، کاملاً شفاف، مناسب آزمایش محلی |
چرا مدلهای تصمیمگیر برای عاملهای هوش مصنوعی مهماند؟
عاملهای هوش مصنوعی بیشتر وقتشان را صرف نوشتن متن خلاقانه نمیکنند. بخش بزرگی از کارشان تصمیمهای کوچک و تکراری است: کدام ابزار صدا زده شود؟ درخواست به کدام مدل برود؟ خروجی امن است یا نه؟ وقت پرسیدن از کاربر رسیده یا نه؟ اگر برای هر کدام از این تصمیمها یک LLM بزرگ صدا زده شود، هزینه و تأخیر بهسرعت بالا میرود.
به همین دلیل الگوی عامل ترکیبی (Hybrid Agent) دارد رایج میشود. در این الگو مدل تصمیمگیر تصمیمهای ساده و تکراری را در چند ده میلیثانیه میگیرد و فقط موارد دشوار به LLM میرسد. کاربردهایی که AWS و Cloudflare نام بردهاند:
مسیریابی مدل و انتخاب ابزار
گاردریل و طبقهبندی سیاستها (Policy Classification)
تریاژ تیکتهای پشتیبانی و تشخیص فوریت
مدیریت حافظه و زمینه در عاملها
تشخیص محتوای مخرب، مثل دامنههای فیشینگ
نمونهی AWS این ایده را خوب نشان میدهد. کاربر میپرسد «هوا چطور است؟» ولی شهری نمیگوید و عامل میخواهد یک شهر را حدس بزند و ابزار آبوهوا را صدا بزند. پیش از اجرای این فراخوانی، Strands Decider دو سؤال بله/خیر را بررسی میکند: آیا آرگومانها از حرفهای خود کاربر آمدهاند؟ آیا هنوز برای فراخوانی ابزار زود است؟ نتیجه این میشود که عامل بهجای گزارش اشتباه، از کاربر میپرسد منظورش کدام شهر است.
برای شروع چه کنیم؟
برای آزمایش رایگان و محلی: Strands Decider 2B با یک دستور pip install strands-decider نصب میشود و روی لپتاپ هم اجرا میشود.
برای استفاده در مقیاس تولید: Clef و Clef-flash روی Workers AI در دسترساند. اگر وزنها را بخواهید، از Hugging Face دانلود کنید.
یک قانون مهم: محاسبات، شمارش و منطق قطعی را در کد نگه دارید و از مدل تصمیمگیر فقط برای قضاوتهای «نرم» استفاده کنید. برای پاسخهای کماطمینان هم همیشه یک مسیر جایگزین (انسان یا LLM) در نظر بگیرید.
جمعبندی
ورود همزمان Cloudflare و AWS نشان میدهد مدلهای تصمیمگیر فقط یک ایدهی جالب استارتاپی نیستند و دارند به یکی از اجزای استاندارد معماری عاملهای هوش مصنوعی تبدیل میشوند. اگر LLM را «مغز متفکر» عامل بدانیم، مدل تصمیمگیر «واکنش سریع» آن است: ارزان، سریع و همیشه با پاسخی در قالب مشخص. با این حال این حوزه هنوز خیلی جوان است و بیشتر اعداد را خود سازندگان اعلام کردهاند. پیش از استفادهی جدی، این مدلها را روی دادهی خودتان آزمایش کنید.
سوالات متداول
مدل تصمیمگیر (Decision Model) چیست؟
مدلی است که متن تولید نمیکند. یک وضعیت و چند سؤال تایپشده میگیرد و در یک گذر موازی، از میان گزینههای تعیینشده انتخاب میکند، امتیاز میدهد یا به سؤال بله/خیر پاسخ میدهد و کنار هر پاسخ احتمال و میزان اطمینان را هم برمیگرداند.
آیا Clef و Strands Decider 2B رایگان و متنباز هستند؟
بله. وزنهای هر دو با مجوز Apache 2.0 در Hugging Face منتشر شدهاند. Clef روی Workers AI کلادفلر هم میزبانی میشود. AWS هم برای Strands Decider علاوه بر وزنها، کد و دادهها و اسکریپتهای آموزش را منتشر کرده است. در مقابل، Jev مدلی اختصاصی است و از طریق API ارائه میشود.
آیا مدل تصمیمگیر میتواند جای ChatGPT یا مدلهای زبانی بزرگ را بگیرد؟
خیر. این مدلها متن تولید نمیکنند و در مسائل پیچیدهی استدلالی ضعیفترند. کاربرد اصلیشان تصمیمهای سریع و تکراری داخل عاملهاست؛ مثل مسیریابی، انتخاب ابزار و گاردریل. کارهای دشوار همچنان به LLM سپرده میشوند.
Strands Decider 2B را میتوان روی لپتاپ اجرا کرد؟
بله. طبق اعلام AWS، این مدل ۲ میلیارد پارامتری روی CPU یا GPU محلی اجرا میشود. میانهی تأخیر آن روی RTX 3090 حدود ۱۱۵ میلیثانیه و روی MacBook با تراشهی M3 برای کارهای کوچک حدود ۱۵۳ میلیثانیه است.
نظرات (۰)
هنوز نظری ثبت نشده است. اولین نفر باشید.