فهرست مطالب
- Qwen-Image-2.1-viggle-turbo چیست؟
- نسخه v0.2.1 چه تفاوتی با Qwen-Image-2.1 اصلی دارد؟
- کاهش فرایند تولید از ۴۰ مرحله به ۶ مرحله
- چه چیزی در نسخه v0.2.1 بهتر شده است؟
- مهمترین قابلیتهای Qwen-Image-2.1-viggle-turbo
- تولید تصویر از متن
- ویرایش تصویر با ۱ تا ۳ تصویر مرجع
- حفظ بهتر ترکیببندی تصویر
- تفاوت LoRA نسخه r256 و r128 چیست؟
- آموزش نصب و راهاندازی Qwen-Image-2.1-viggle-turbo
- پیشنیازهای نصب
- تنظیمات مهم برای اجرای نسخه ۶ مرحلهای
- اجرای مدل در ComfyUI
- کیفیت تصویر و وضوحهای پیشنهادی
- محدودیتهای Qwen-Image-2.1-viggle-turbo
- ضعف بیشتر در نوشتههای کوچک و متراکم
- محدودیت در ویرایشهای پیچیده و حفظ هویت
- مجوز Qwen-Image-2.1-viggle-turbo و استفاده تجاری
- Qwen-Image-2.1-viggle-turbo برای چه کسانی مناسب است؟
- جمعبندی؛ آیا Qwen Image 2.1 Viggle Turbo ارزش استفاده دارد؟
سرعت تولید تصویر همچنان یکی از چالشهای مهم مدلهای مولد تصویری است. هرچه تعداد مراحل پردازش یک مدل کمتر شود، امکان ساخت تصویر در زمان کوتاهتر و با هزینه محاسباتی پایینتر افزایش پیدا میکند؛ اما کاهش بیش از اندازه مراحل معمولاً میتواند با افت کیفیت، تغییر ترکیببندی یا کاهش جزئیات همراه باشد.
Qwen-Image-2.1-viggle-turbo تلاشی برای حل همین مسئله است. این مدل که توسط Viggle بر پایه Qwen-Image-2.1 ساخته شده، در نسخه v0.2.1 میتواند بسیاری از وظایف تولید و ویرایش تصویر را تنها با ۶ مرحله پردازشی انجام دهد؛ در حالی که مدل پایه برای فرایند معمول خود از ۴۰ مرحله استفاده میکند.
طبق اطلاعات منتشرشده توسط Viggle، نسخه Turbo در آزمایشهای ارائهشده حدود ۵ برابر سریعتر از مدل پایه ۴۰ مرحلهای بوده و در بسیاری از نمونهها کیفیتی نزدیک به آن ارائه کرده است. با این حال، این افزایش سرعت بدون محدودیت نیست و در مواردی مانند نوشتههای کوچک، ترکیب چند تصویر مرجع و ویرایشهای حساس به هویت، هنوز میتوان تفاوتهایی با مدل اصلی مشاهده کرد.
در ادامه، نسخه v0.2.1 را از نظر ساختار، سرعت، کیفیت، نصب، ComfyUI، انواع LoRA و محدودیتهای واقعی بررسی میکنیم.
Qwen-Image-2.1-viggle-turbo چیست؟
Qwen-Image-2.1-viggle-turbo یک نسخه تقطیرشده از Qwen-Image-2.1 است که Viggle آن را با استفاده از روشهای تقطیر مدل از جمله Distribution Matching Distillation توسعه داده است.
منظور از تقطیر در اینجا این است که یک مدل سریعتر تلاش میکند رفتار و خروجی مدل اصلی را با تعداد مراحل پردازشی بسیار کمتری بازتولید کند.
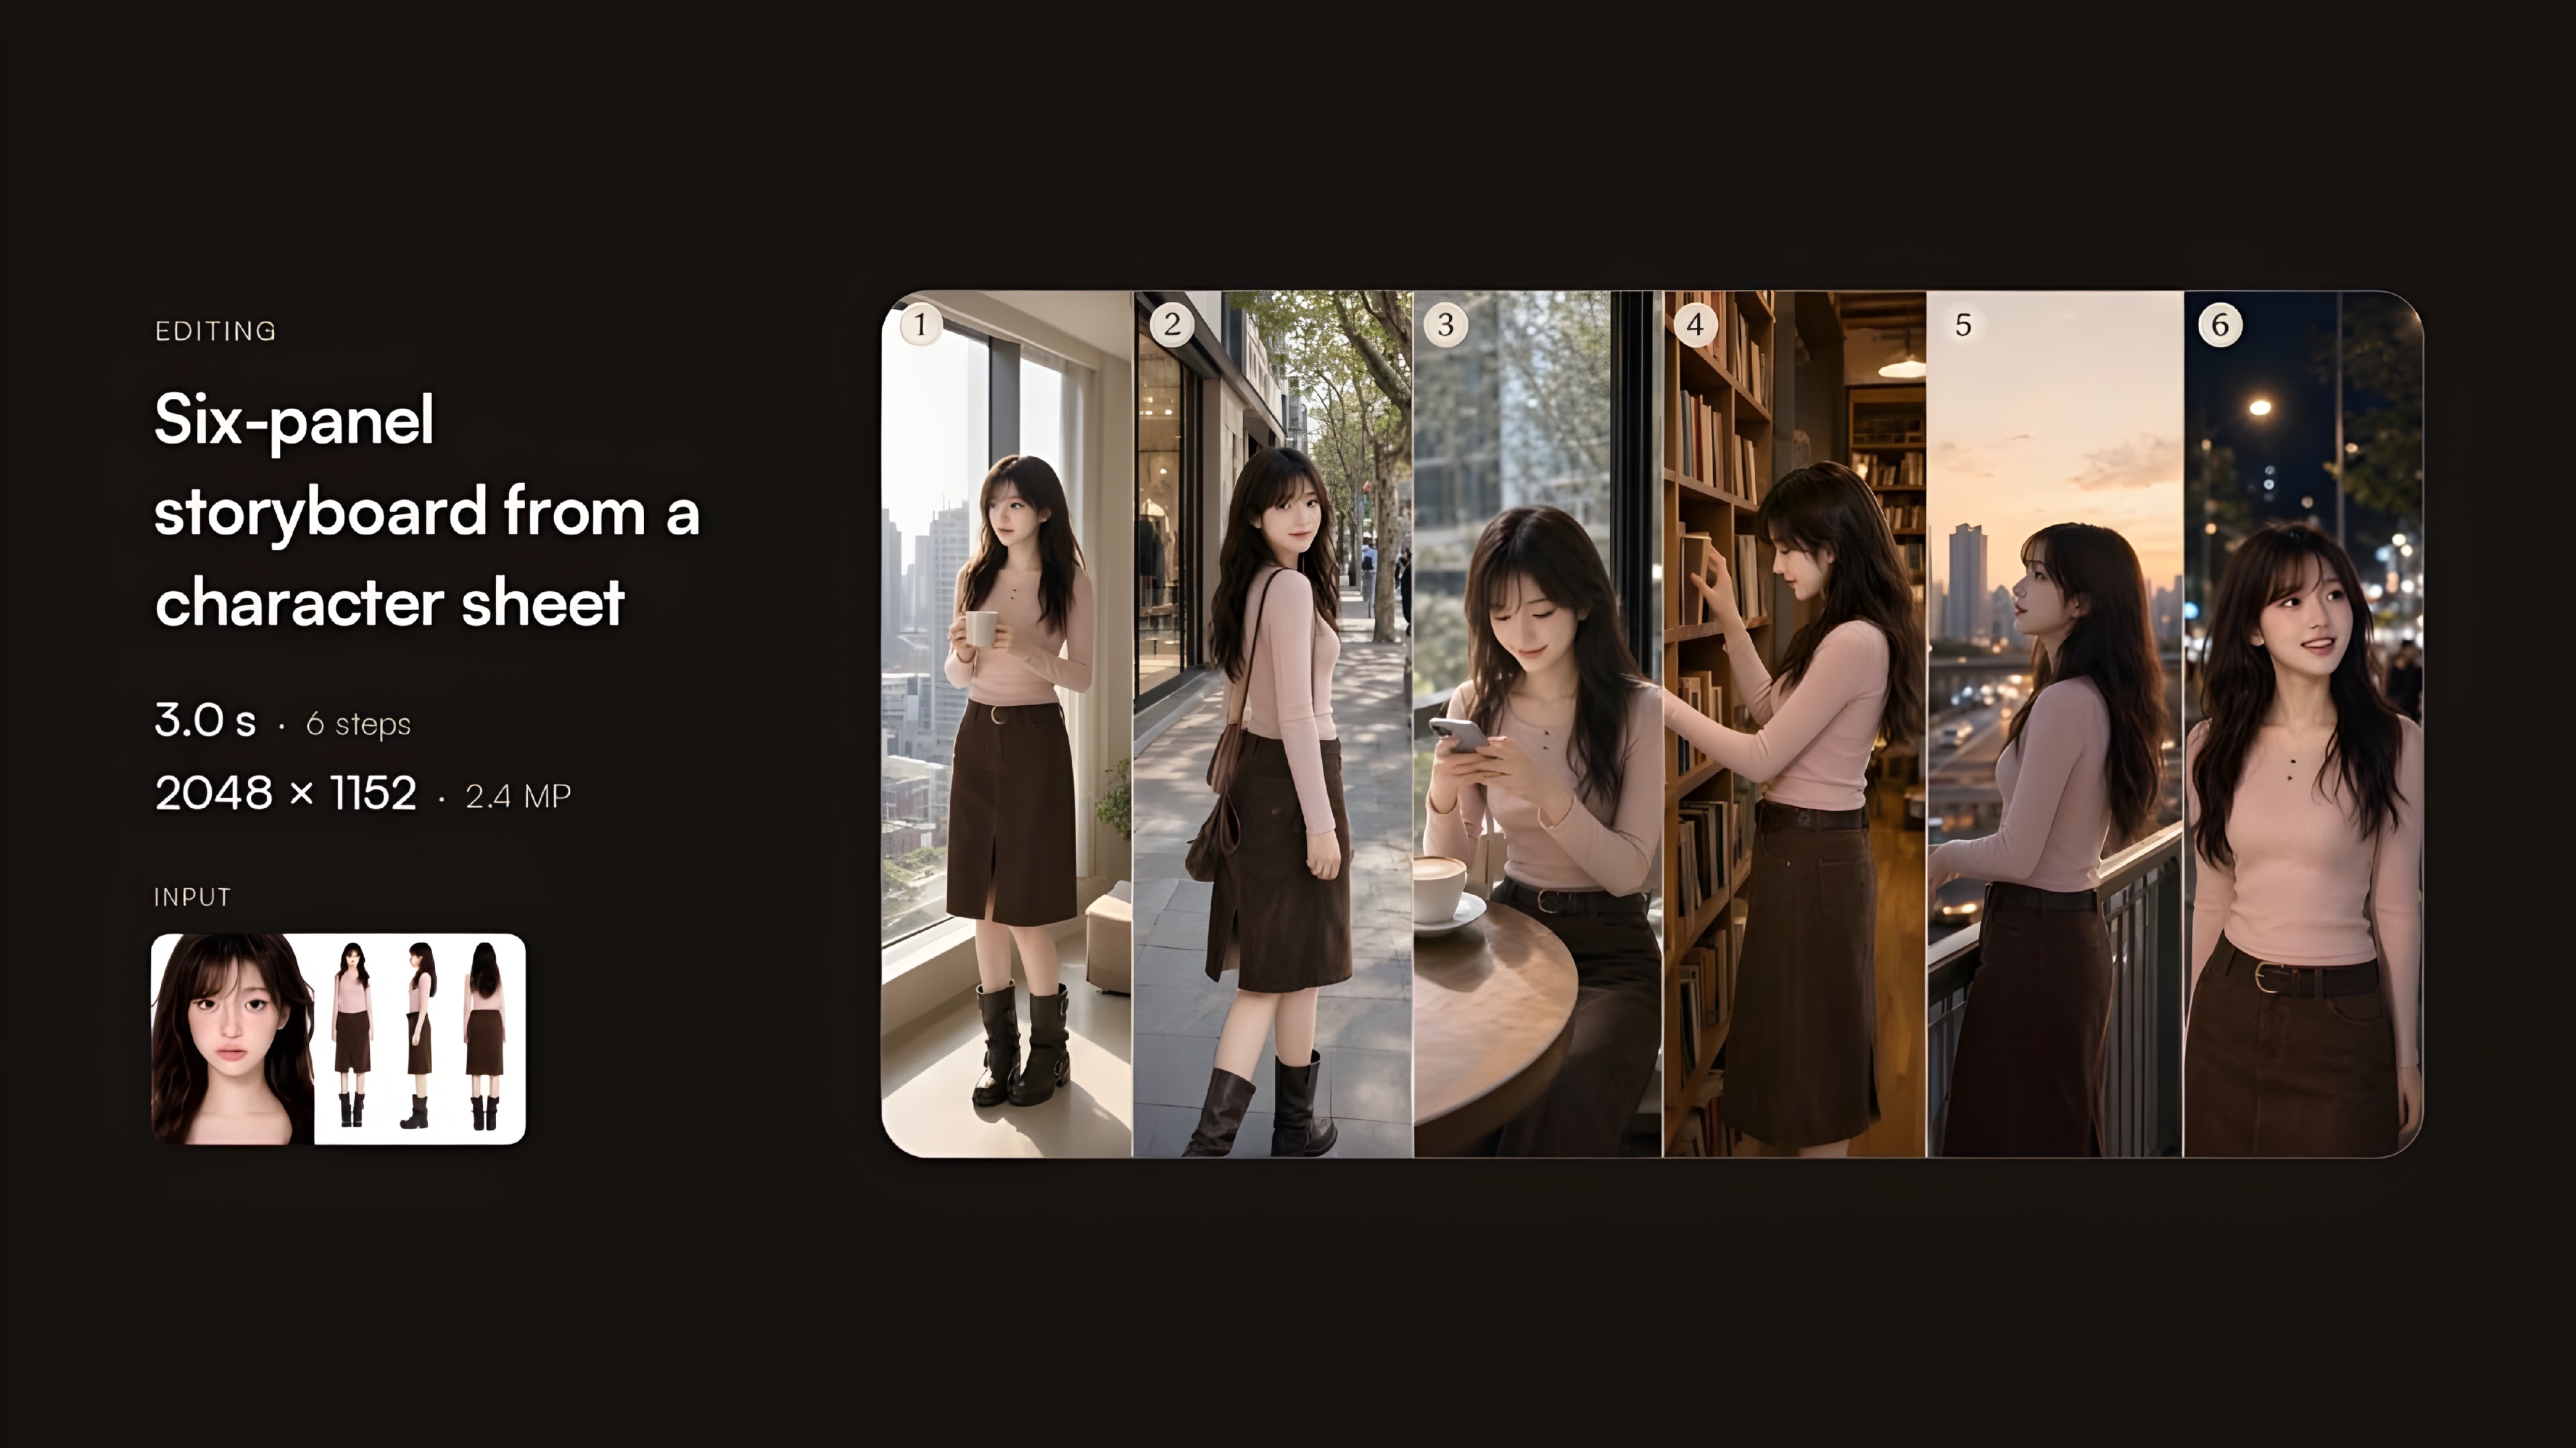
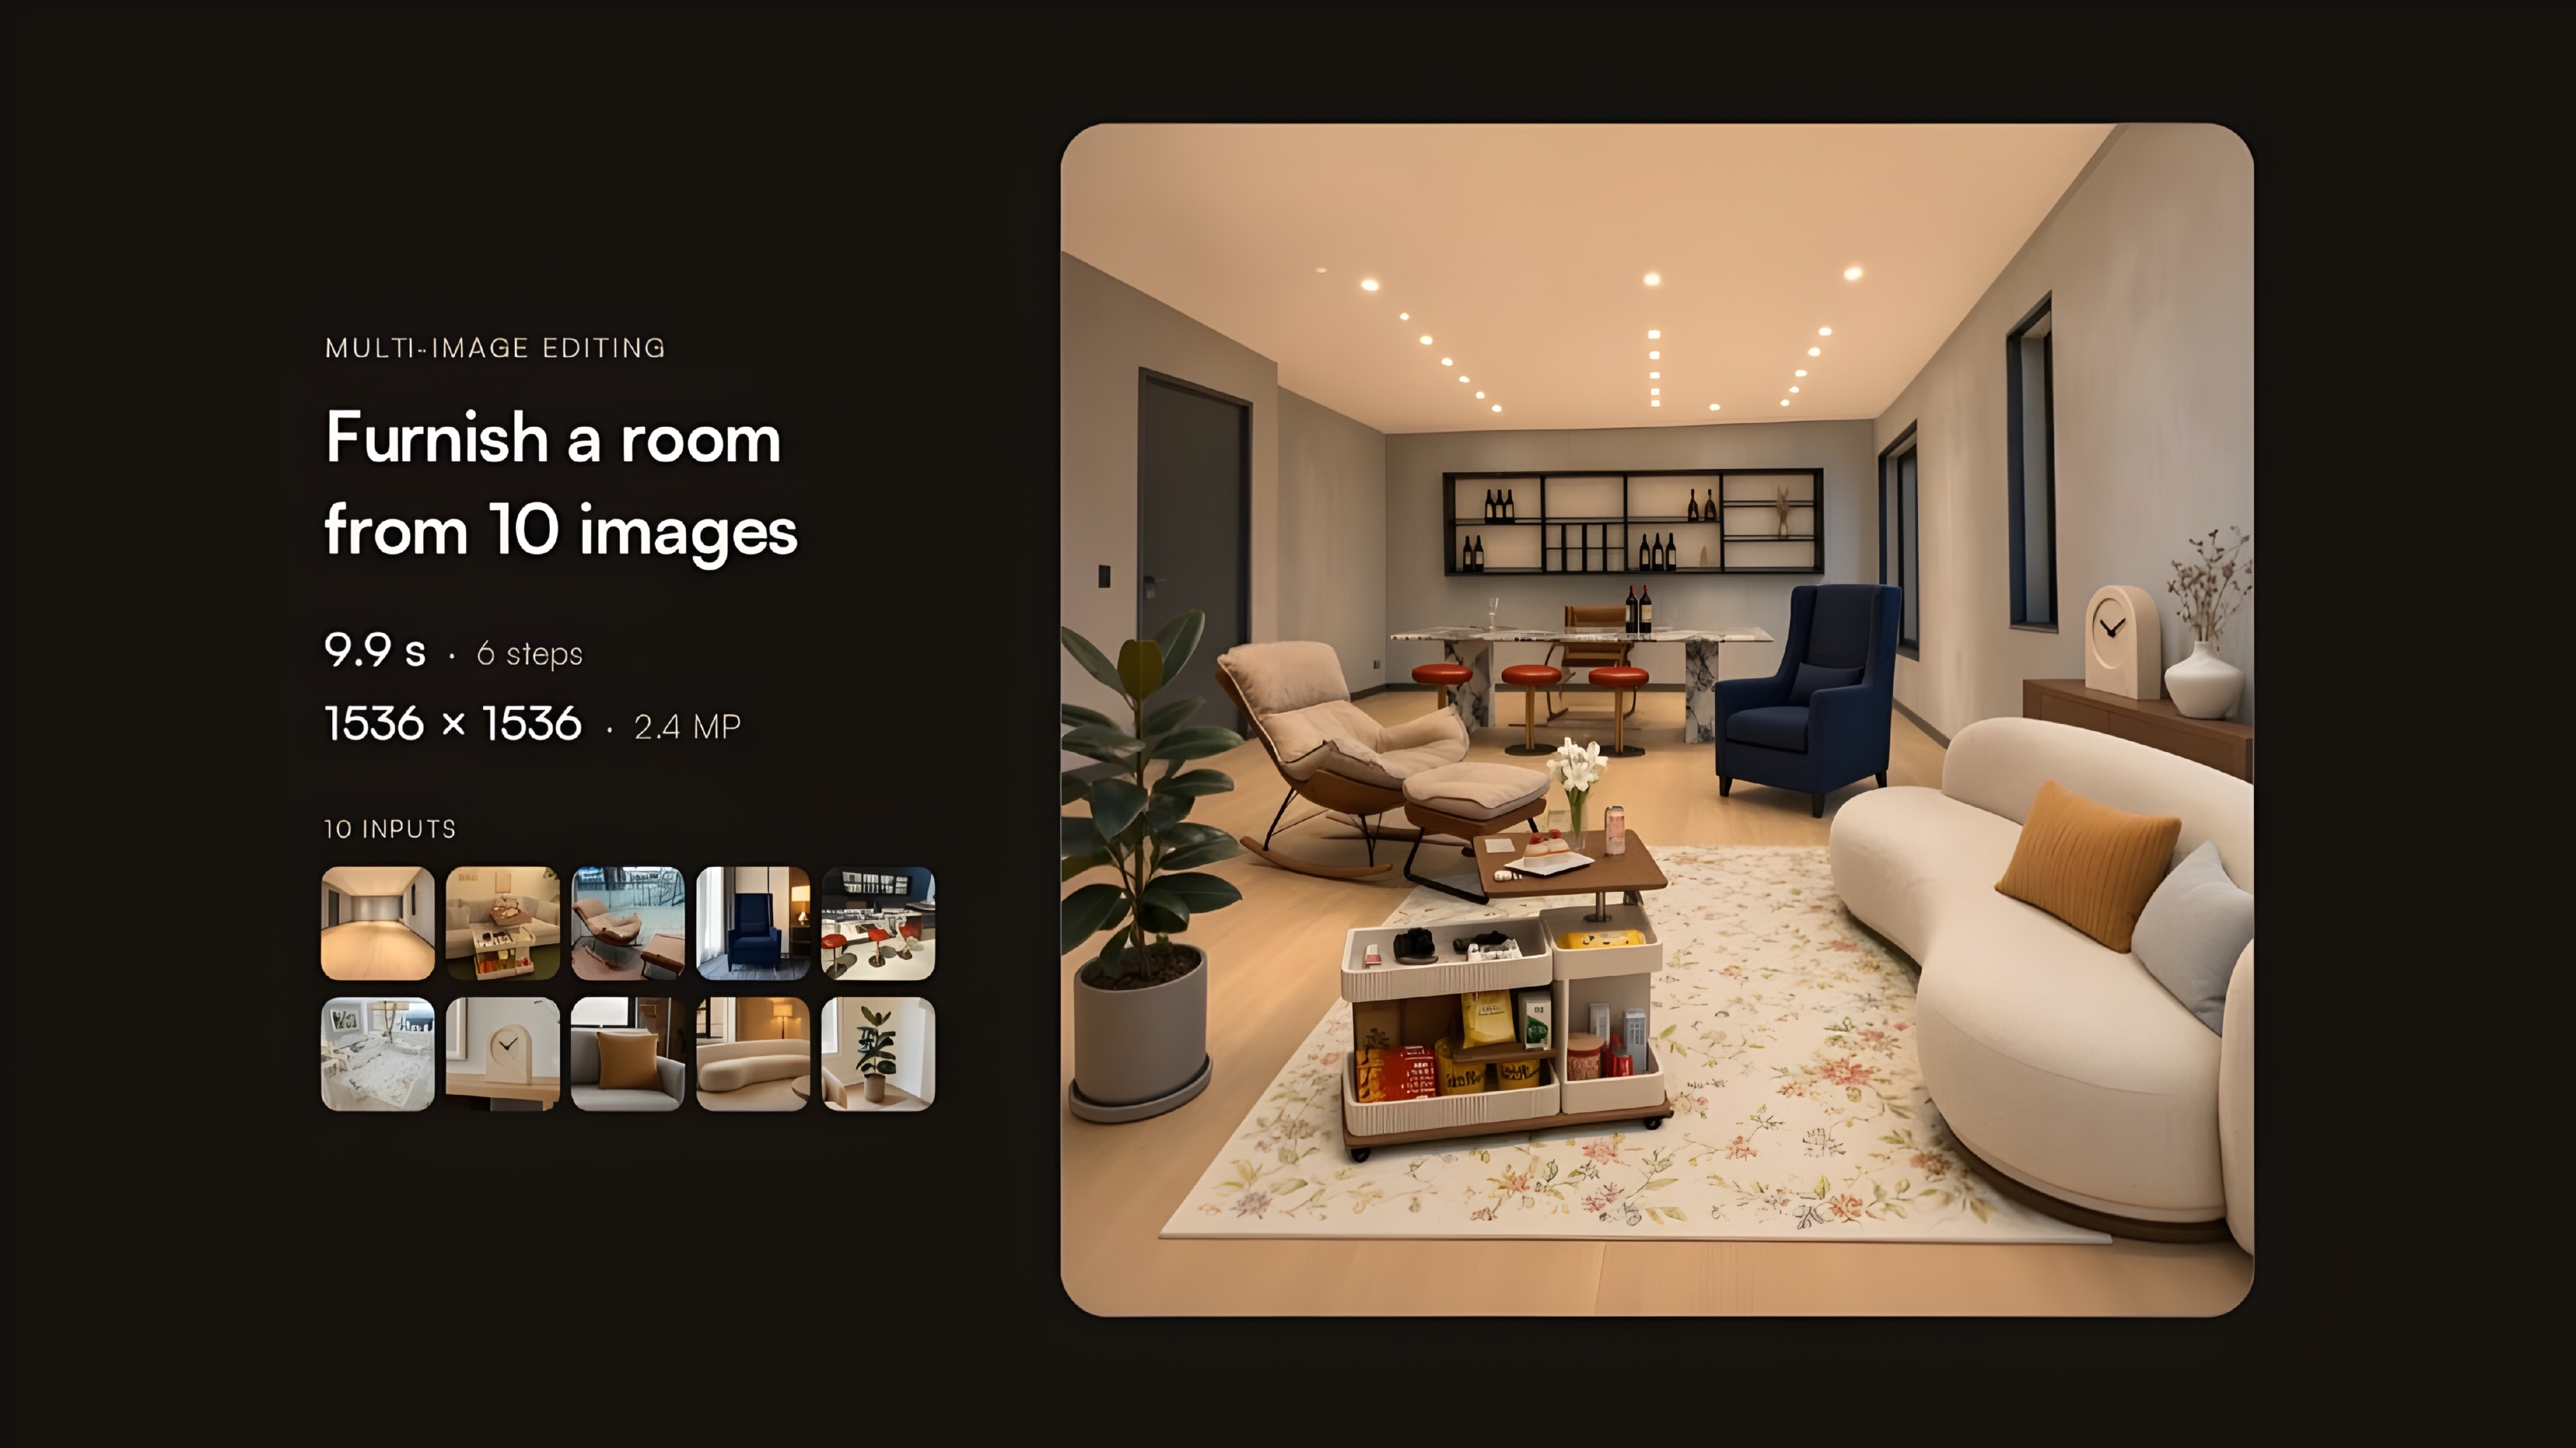
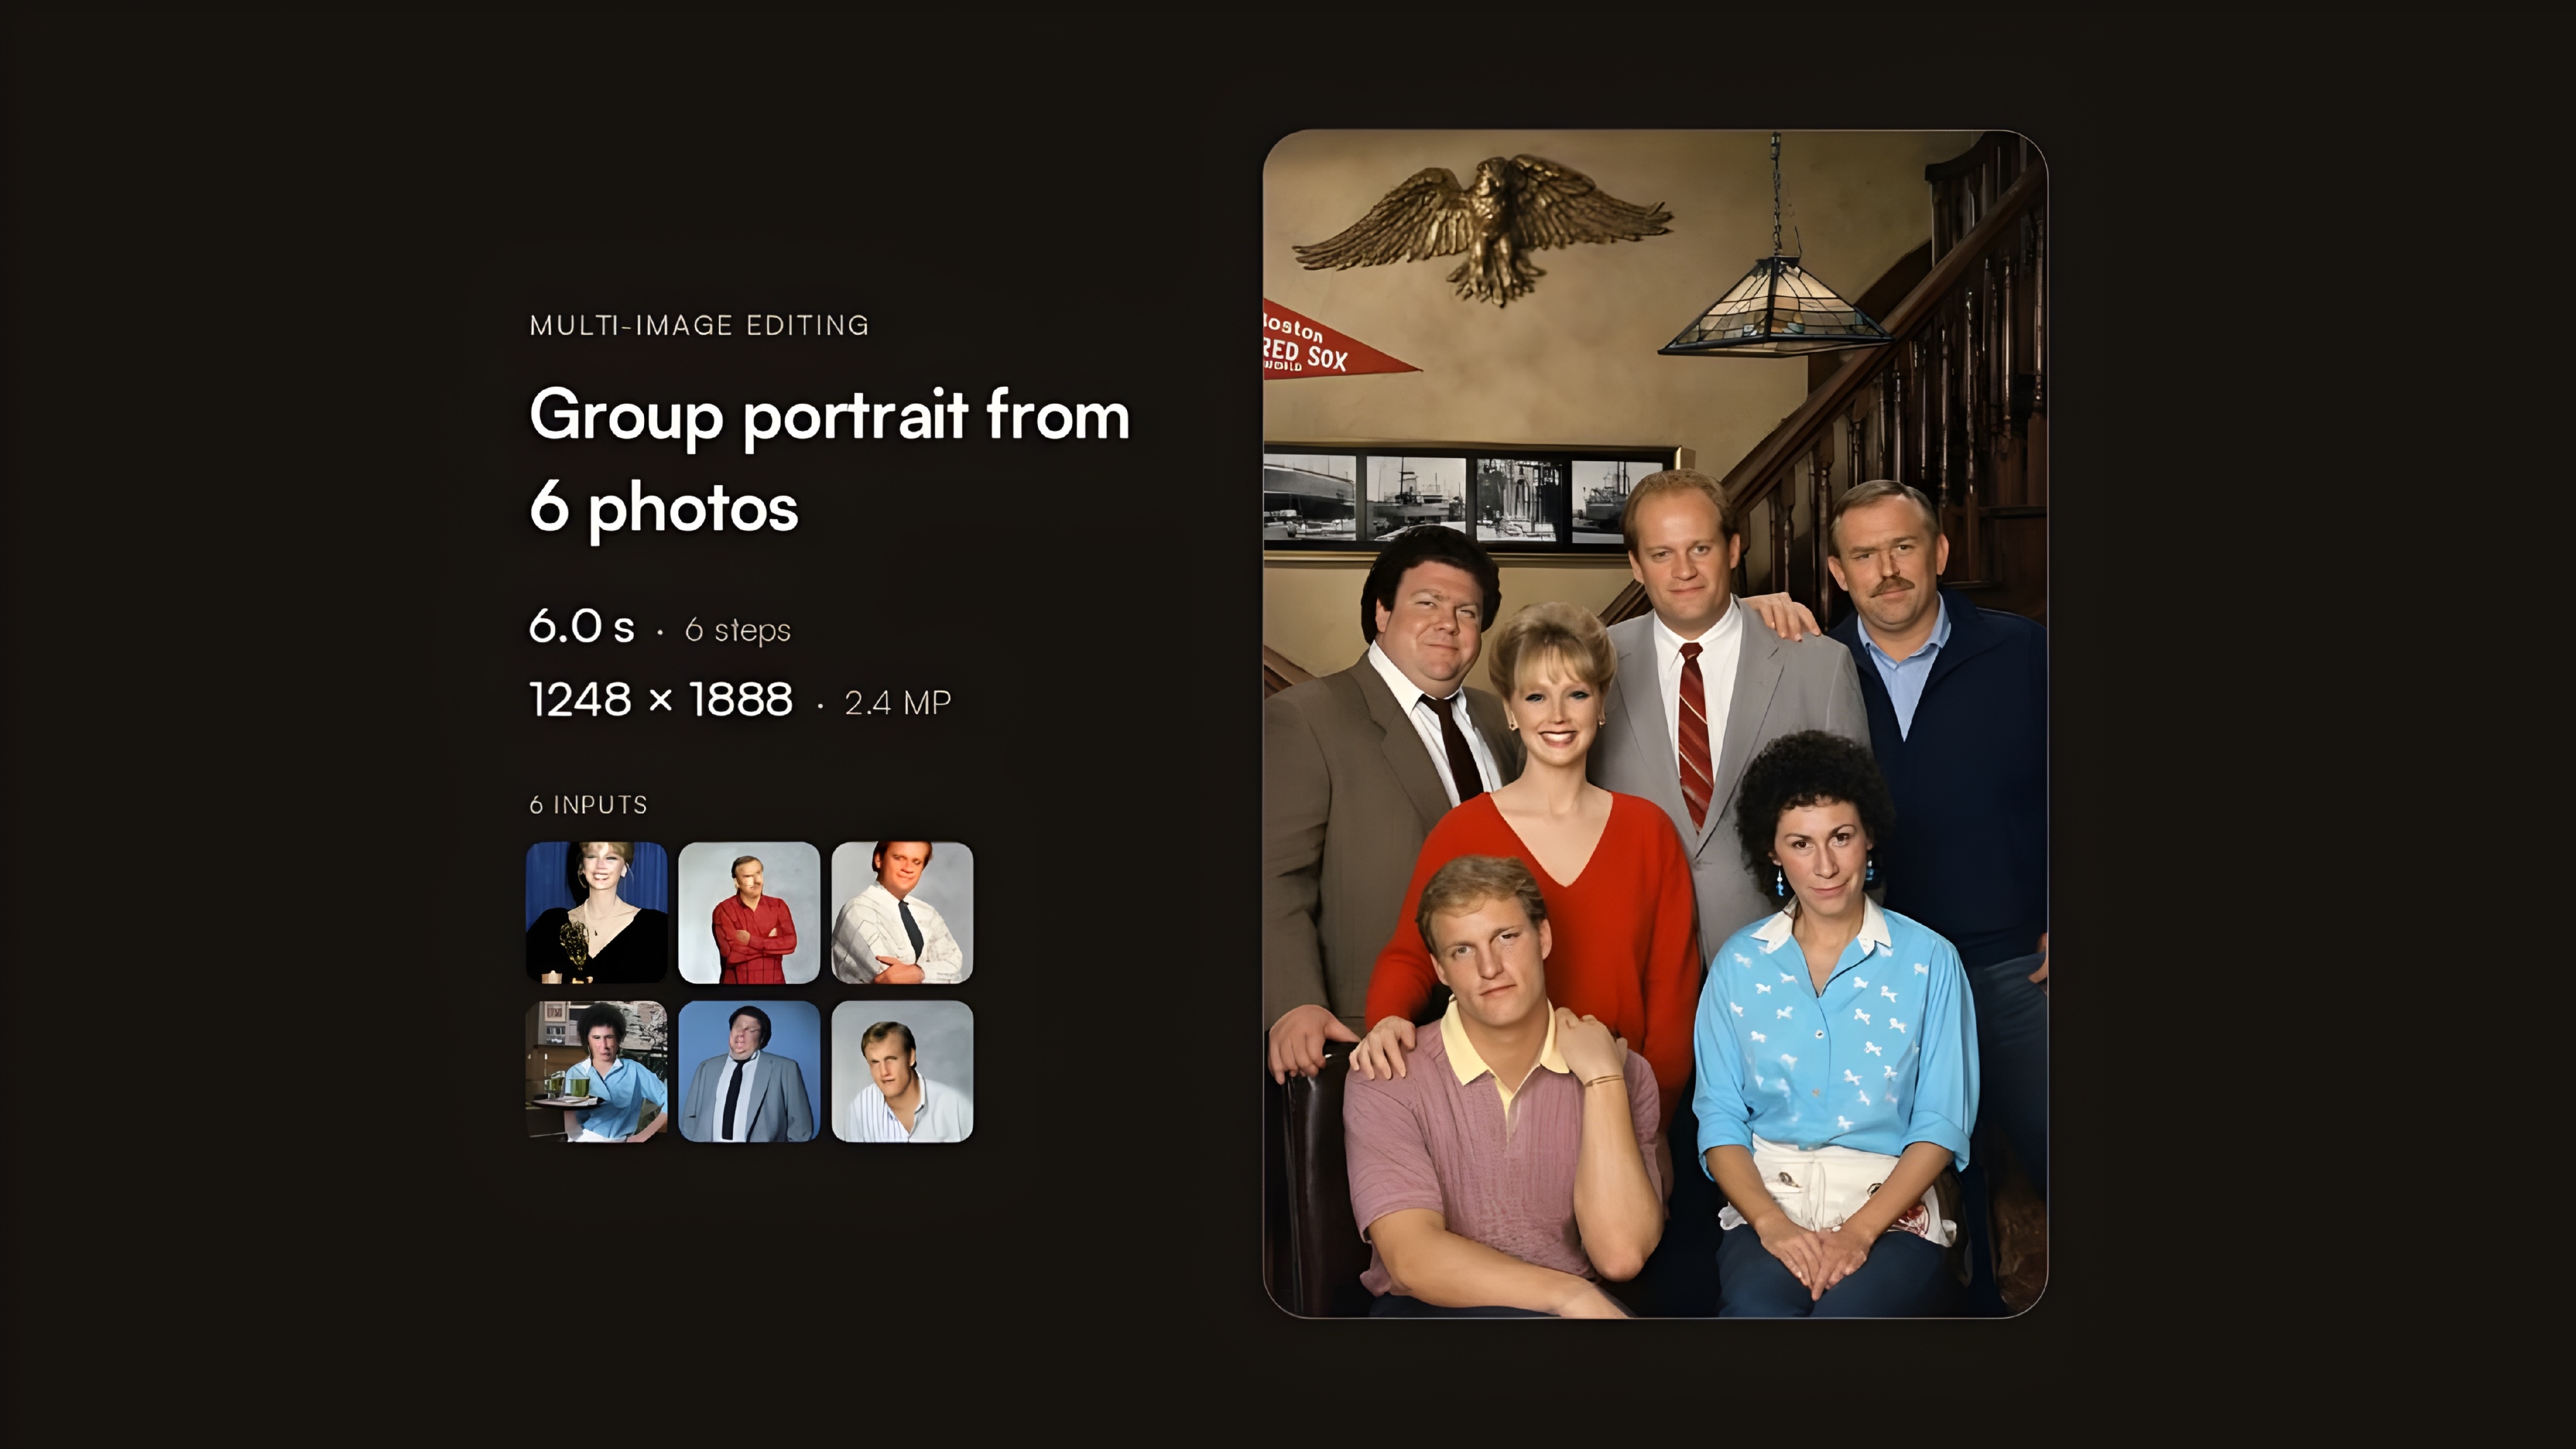
این نسخه هم برای تولید تصویر از متن و هم برای ویرایش تصویر براساس دستور متنی طراحی شده است. نسخه v0.2.1 میتواند در حالت ویرایش با ۱ تا ۳ تصویر مرجع کار کند.
خود Qwen-Image-2.1 نیز یک مدل تصویری از خانواده Qwen است که تولید و ویرایش تصویر را در یک سامانه واحد ترکیب میکند. Qwen در معرفی رسمی نسخه 2.1 اعلام کرده که بخش تولید بصری این مدل ۷ میلیارد پارامتر دارد و قابلیتهایی مانند تولید و ویرایش تصویر را در یک معماری یکپارچه ارائه میکند.
تفاوت اصلی نسخه Viggle Turbo در این است که تمرکز آن نه روی تغییر ماهیت مدل، بلکه روی کاهش شدید تعداد مراحل لازم برای رسیدن به نتیجه قابل قبول قرار گرفته است.
نسخه v0.2.1 چه تفاوتی با Qwen-Image-2.1 اصلی دارد؟
نسخه v0.2.1 در ۲۴ سپتامبر ۲۰۲۶ منتشر شد و در زمان نگارش این مقاله، نسخه توصیهشده در مخزن رسمی Viggle محسوب میشود.
مهمترین تفاوت آن با مدل پایه را میتوان در تعداد مراحل پردازشی مشاهده کرد.
کاهش فرایند تولید از ۴۰ مرحله به ۶ مرحله
مدل پایه Qwen-Image-2.1 در مقایسههای Viggle با ۴۰ مرحله اجرا شده است؛ اما Qwen-Image-2.1-viggle-turbo v0.2.1 تنها از ۶ مرحله استفاده میکند.
این موضوع اهمیت زیادی دارد، زیرا تعداد کمتر مراحل میتواند زمان تولید تصویر و هزینه پردازشی را کاهش دهد.
Viggle اعلام کرده که اجرای کامل نسخه Turbo در مقایسه با مدل پایه ۴۰ مرحلهای حدود ۵ برابر سریعتر است. این عدد باید بهعنوان نتیجه آزمایش منتشرشده توسط سازنده Turbo در نظر گرفته شود و الزاماً به این معنا نیست که روی تمام کارتهای گرافیک، وضوحها و تنظیمات دقیقاً همین نسبت سرعت مشاهده خواهد شد.
چه چیزی در نسخه v0.2.1 بهتر شده است؟
v0.2.1 ادامه نسخه v0.2 محسوب میشود. نسخه v0.2 بر پایه checkpoint مرحله ۶۰۰ منتشر شده بود، در حالی که v0.2.1 از checkpoint مرحله ۷۰۰ استفاده میکند.
طبق اندازهگیریهای Viggle، نسخه جدید کمی شارپتر شده و تنوع خروجی آن نیز نسبت به نسخه قبلی به مدل پایه نزدیکتر است.
یکی از مشکلات نسخههای بسیار سریع مدلهای تصویری این است که ممکن است خروجیهای مختلف بیش از اندازه به یکدیگر شبیه شوند یا موقعیت سوژه نسبت به مدل اصلی تغییر کند. دادههای منتشرشده نشان میدهد v0.2 و v0.2.1 در حفظ ترکیببندی پیشرفت محسوسی نسبت به v0.1 داشتهاند.
مهمترین قابلیتهای Qwen-Image-2.1-viggle-turbo
این مدل صرفاً یک نسخه سریع برای ساخت تصویر نیست و چند نوع جریان کاری را پوشش میدهد.
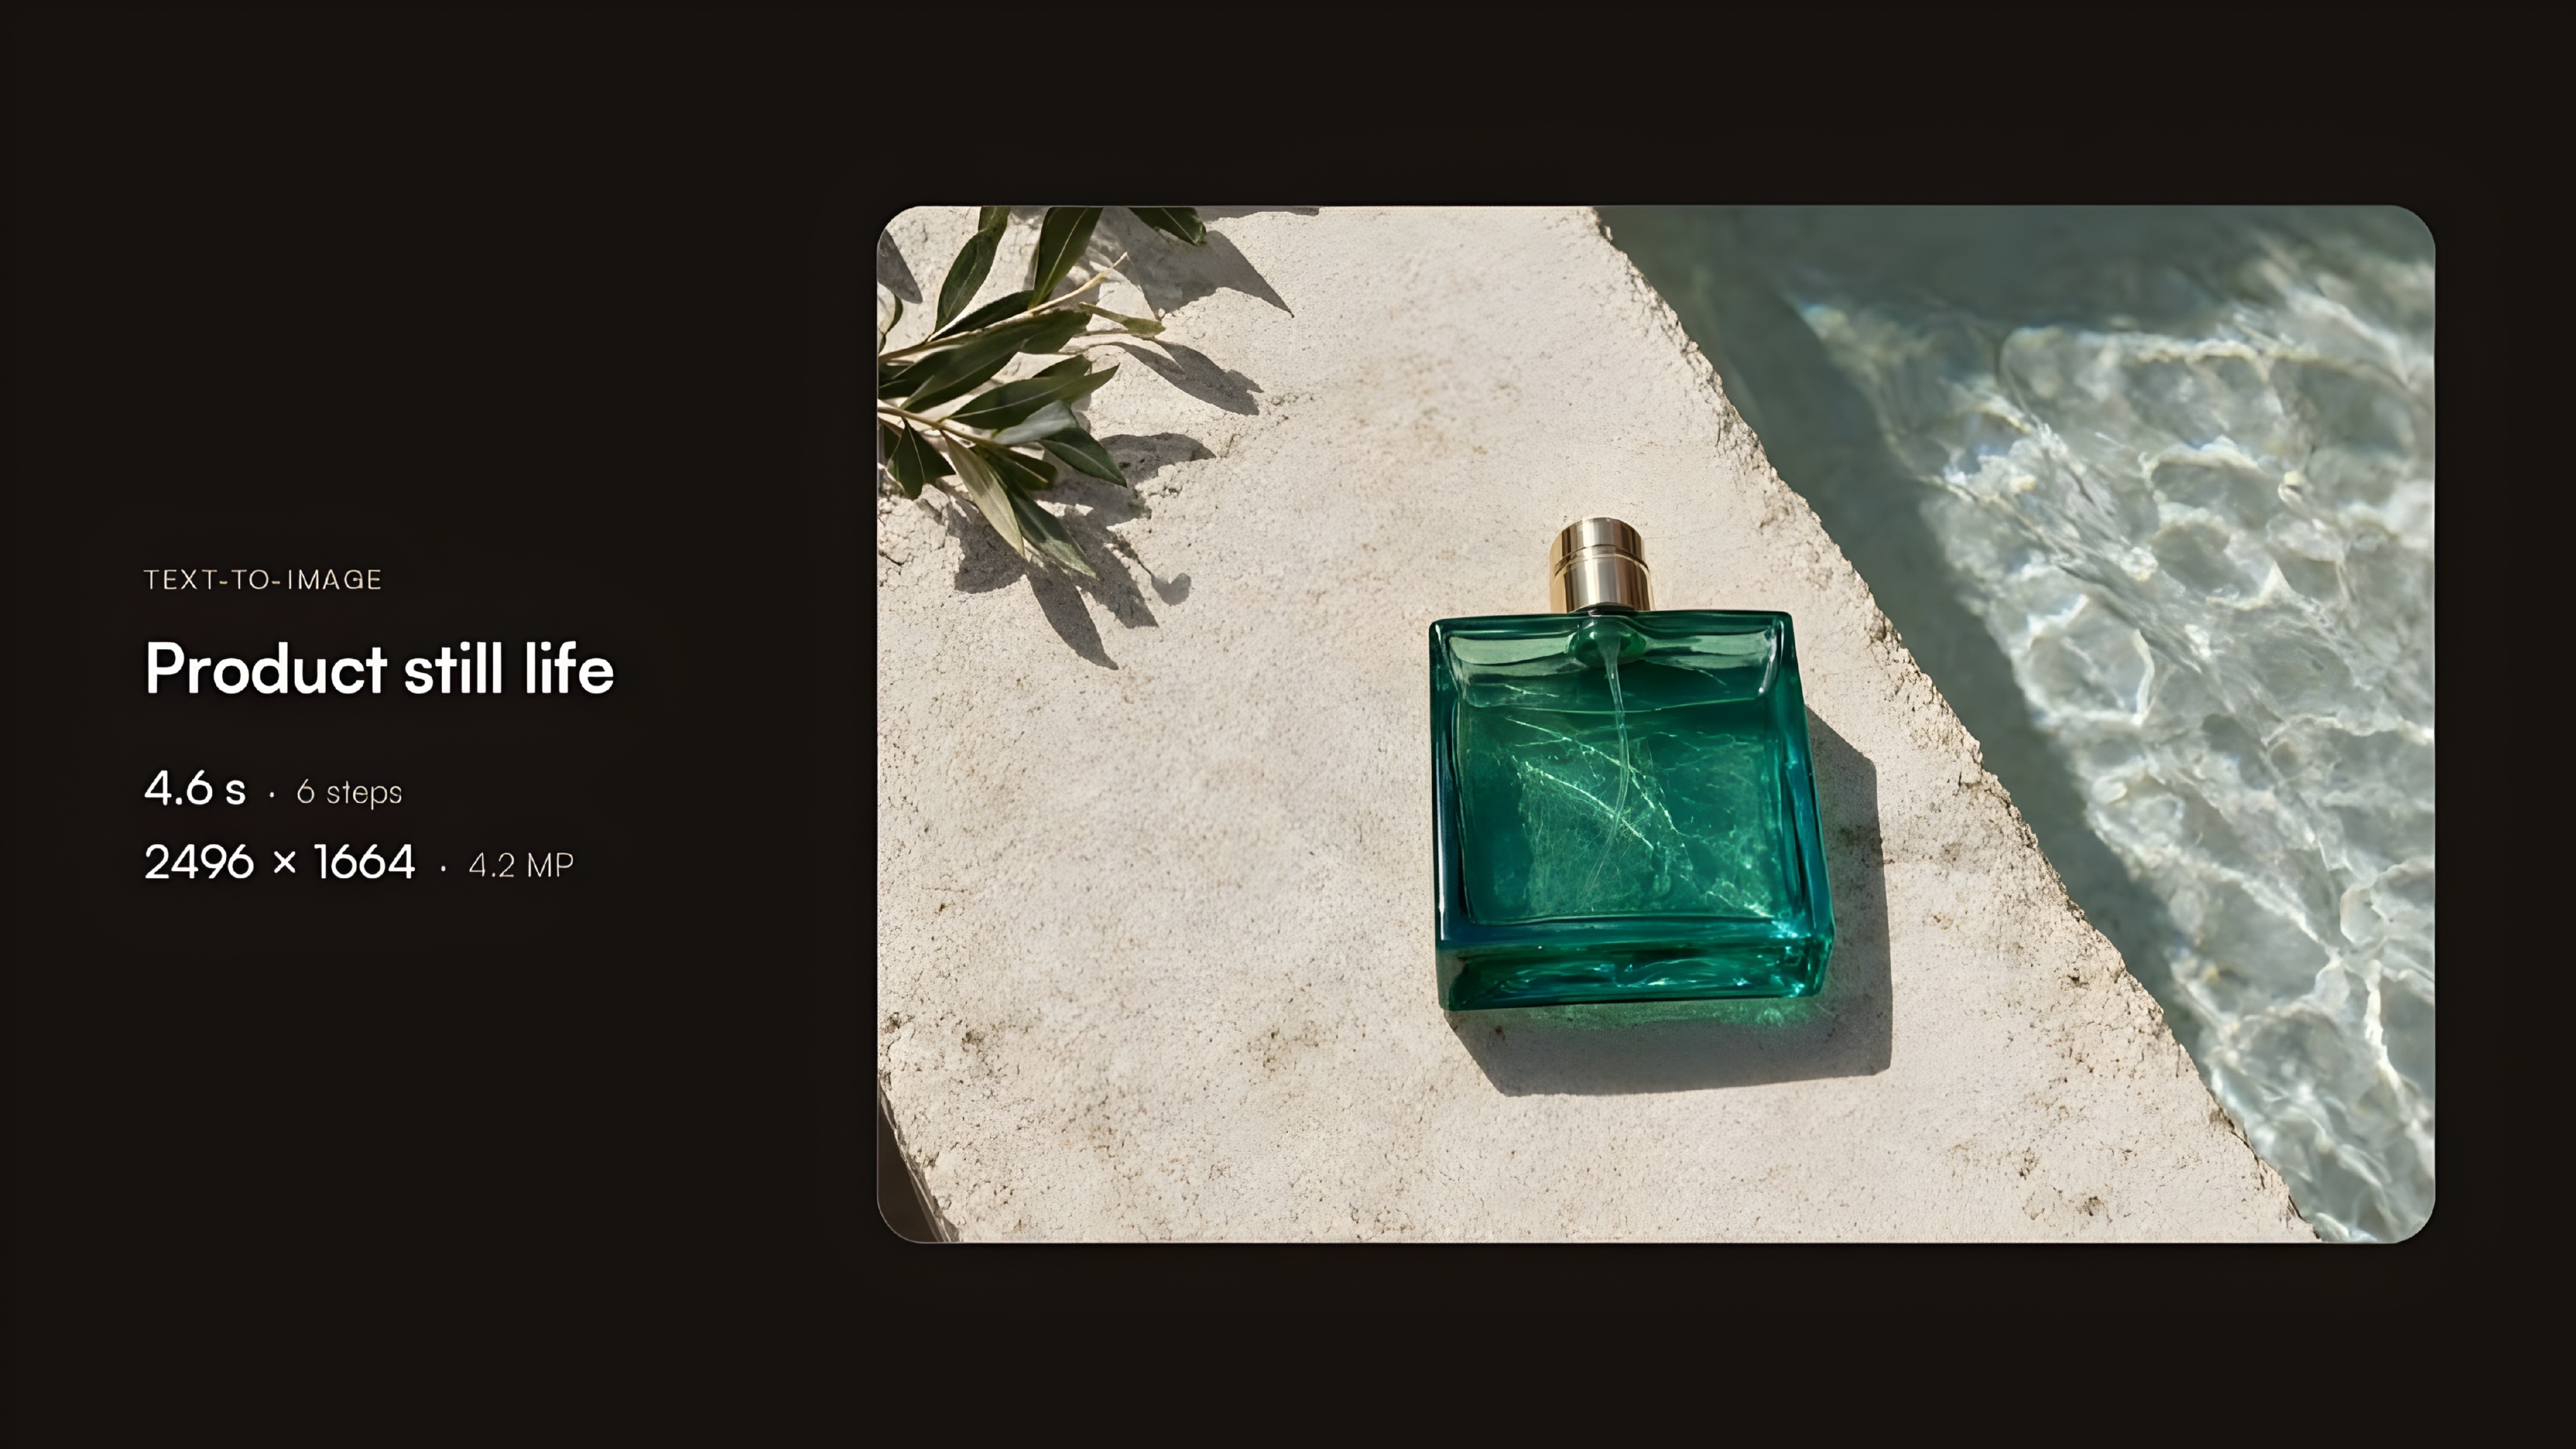
تولید تصویر از متن
کاربر میتواند مانند بسیاری از مدلهای مولد تصویر، یک توضیح متنی وارد کند و براساس آن تصویر بسازد.
برای نمونه، میتوان ویژگیهایی مانند سوژه، محیط، نور، زاویه دوربین، سبک بصری و جزئیات صحنه را در دستور مشخص کرد.
مزیت اصلی نسخه Turbo این است که برای رسیدن به خروجی به مراحل بسیار کمتری نیاز دارد. این موضوع در جریانهای کاری که تعداد زیادی تصویر آزمایشی تولید میشود اهمیت بیشتری پیدا میکند؛ زیرا کاربر میتواند سریعتر چند ایده، ترکیببندی یا بذر تصادفی مختلف را امتحان کند.
ویرایش تصویر با ۱ تا ۳ تصویر مرجع
Qwen-Image-2.1-viggle-turbo علاوه بر تولید تصویر، از ویرایش مبتنی بر دستور نیز پشتیبانی میکند.
در دادههای آموزشی این نسخه تا ۳ تصویر مرجع استفاده شده است. برای مثال میتوان یک تصویر را به مدل داد و از آن خواست پسزمینه را تغییر دهد، در حالی که سوژه اصلی تا حد امکان ثابت باقی بماند.
ترتیب تصاویر مرجع نیز اهمیت دارد؛ زیرا شمارهگذاری تصویرها در دستور براساس ترتیب ورود آنها تعیین میشود.
البته باید میان قابلیتهای مدل پایه Qwen-Image-2.1 و نسخه تقطیرشده Viggle Turbo تفاوت قائل شد. مدل پایه قابلیتهای گستردهتری برای استفاده از تعداد بیشتری تصویر مرجع دارد، اما نسخه Turbo مشخصاً با ۱ تا ۳ مرجع آموزش دیده است.
حفظ بهتر ترکیببندی تصویر
یکی از اهداف نسخههای v0.2 و v0.2.1 کاهش جابهجایی ناخواسته ترکیببندی بوده است.
در نسخههای اولیه ممکن بود هنگام کاهش تعداد مراحل، سوژه جابهجا شود، عناصر تصویر با یکدیگر ادغام شوند یا اشکال شبحمانند ایجاد شوند.
طبق آزمایشهای داخلی Viggle روی مجموعهای از درخواستها، نسخههای جدید در پیروی از ساختار خروجی مدل پایه و جلوگیری از تغییر محسوس چیدمان بهتر عمل کردهاند.
این ویژگی برای کاربرانی که میخواهند یک نتیجه مشخص را با سرعت بیشتر بازتولید کنند اهمیت زیادی دارد.
تفاوت LoRA نسخه r256 و r128 چیست؟
برای v0.2.1 دو فایل مهم LoRA منتشر شده است:
r256 نسخه اصلی با رتبه ۲۵۶ و حجمی در حدود ۱.۳ گیگابایت است.
r128 نسخه کوچکتر با رتبه ۱۲۸ و حجمی در حدود ۶۸۰ مگابایت است.
نسخه r128 با کاهش رتبه از r256 ایجاد شده و برای جریانهای کاری ComfyUI نیز مورد استفاده قرار گرفته است.
براساس اندازهگیری منتشرشده در مدلکارت، اختلاف خروجی r128 با r256 بسیار محدود گزارش شده است. در نتیجه، برای کاربری که کاهش مصرف حافظه یا حجم فایل اهمیت دارد، r128 میتواند گزینه عملی مناسبی باشد.
در مقابل، اگر هدف بیشترین وفاداری به نسخه کامل منتشرشده باشد و محدودیت حافظه مسئله اصلی نباشد، r256 انتخاب طبیعیتری است.
آموزش نصب و راهاندازی Qwen-Image-2.1-viggle-turbo
راه رسمی استفاده از این نسخه بر پایه کتابخانه Diffusers و بارگذاری LoRA روی Qwen-Image-2.1 است.
پیشنیازهای نصب
برای اجرای محلی به محیط مناسب پایتون و وابستگیهایی مانند موارد زیر نیاز دارید:
torch
transformers
accelerate
safetensors
peft
pillow
در مدلکارت نسخه v0.2.1 اشاره شده که در زمان انتشار، QwenImage21Pipeline هنوز وارد نسخه انتشاریافته Diffusers نشده بود و به همین دلیل یک نسخه مشخص از مخزن Diffusers پیشنهاد شده است.
این نکته مهم است، زیرا دستور نصب ابزارهای هوش مصنوعی ممکن است در مدت کوتاهی تغییر کند. بنابراین قبل از اجرای کد در آینده، همیشه README فعلی مخزن رسمی را بررسی کنید.
تنظیمات مهم برای اجرای نسخه ۶ مرحلهای
Viggle برای v0.2.1 یک برنامه مشخص ششمرحلهای پیشنهاد کرده است:
[1.0, 0.9375, 0.875, 0.75, 0.5, 0.25]
تعداد مراحل نیز باید روی ۶ قرار گیرد.
یکی دیگر از نکات مهم، استفاده نکردن از Classifier-Free Guidance یا CFG در این تنظیم است. مقدار true_cfg_scale برابر ۱ در نظر گرفته میشود.
سازنده همچنین توصیه کرده تنظیمات Sigma خودسرانه تغییر نکنند. دلیل این موضوع آن است که بخش مهمی از تصمیمگیری درباره ترکیببندی تصویر در قسمت ابتدایی مسیر نویز انجام میشود و تغییر غیر اصولی مراحل ممکن است باعث افت جزئیات یا جابهجایی عناصر شود.
بنابراین اگر هدف شما بازتولید کیفیت منتشرشده در نمونههای رسمی است، بهتر است ابتدا دقیقاً با تنظیمات پیشنهادی سازنده شروع کنید.
اجرای مدل در ComfyUI
برای ComfyUI نیز فایلها، گرههای سفارشی و جریانهای کاری آماده در مخزن قرار گرفتهاند.
نسخه پیشنهادی جریان کاری از LoRA کوچکتر r128 استفاده میکند و گره ویژهای برای برنامه Sigma در اختیار کاربر قرار میدهد.
نکته فنی مهم این است که Viggle استفاده از LoRA بهصورت ادغامنشده در زمان اجرا را توصیه کرده است. براساس آزمایشهای منتشرشده، ادغام مستقیم LoRA در وزنهای bf16 یا int8 میتواند بخشی از بهروزرسانیهای ظریف وزنها را از بین ببرد.
بنابراین کاربران حرفهای ComfyUI بهتر است به جای فرض اینکه هر روش بارگذاری LoRA نتیجه یکسانی ایجاد میکند، جریان کاری منتشرشده در مخزن را مبنا قرار دهند.
کیفیت تصویر و وضوحهای پیشنهادی
داده آموزشی مدل روی چند محدوده وضوح متمرکز بوده است.
برای نسبت تصویر ۱:۱، ابعاد ۱۰۲۴×۱۰۲۴ یکی از اندازههای اصلی محسوب میشود. برای نسبتهای دیگر نیز اندازههایی متناسب با مساحت تصویر پیشنهاد شدهاند؛ برای نمونه ۱۳۷۶×۷۶۸ برای نسبت ۱۶:۹ در محدوده تقریبی یک مگاپیکسل.
مدل میتواند در اندازههای دیگر هم کار کند، اما استفاده از اندازههایی نزدیک به توزیع آموزشی معمولاً نقطه شروع منطقیتری است.
برای تولید متنهای کوچک و متراکم داخل تصویر نیز سازنده اشاره کرده که استفاده از ۸ مرحله در بعضی نمونهها کیفیت نوشته را بهتر کرده است.
بنابراین «۶ مرحله» را باید تنظیم عمومی توصیهشده بدانیم، نه اینکه در تمام شرایط تنها گزینه ممکن باشد.
محدودیتهای Qwen-Image-2.1-viggle-turbo
سرعت بالا مزیت اصلی این نسخه است، اما نباید آن را بدون توجه به محدودیتها جایگزین کامل مدل پایه دانست.
ضعف بیشتر در نوشتههای کوچک و متراکم
واضحترین اختلاف گزارششده با مدل ۴۰ مرحلهای مربوط به تولید نوشتههای کوچک و پرجزئیات داخل تصویر است.
مدل پایه در این سناریو همچنان عملکرد بهتری دارد.
Viggle برای نمونههای دارای متن متراکم، اجرای ۸ مرحلهای را نیز آزمایش کرده و گزارش داده است که این تنظیم میتواند نوشتههای کوچک را تمیزتر تولید کند.
اگر پروژه شما شامل پوستر، رابط کاربری، اینفوگرافیک یا تصاویر دارای متن زیاد است، بهتر است خروجی Turbo را حتماً با مدل اصلی مقایسه کنید.
محدودیت در ویرایشهای پیچیده و حفظ هویت
ویرایشهای چندمرجعی پیچیده، تعویض چهره و دستورهایی که همزمان چند محدودیت دارند، همچنان میتوانند برای نسخه Turbo دشوار باشند.
در برخی شرایط ممکن است سوژه تکرار شود، اثر شبح ایجاد شود یا هویت فرد بهطور کامل حفظ نشود.
بنابراین برای پروژههایی که ثبات دقیق هویت، محصول یا شخصیت حیاتی است، نباید صرفاً براساس سرعت تصمیم گرفت.
انتخاب درست باید بر اساس نوع پروژه باشد: برای آزمایش سریع ایدهها، Turbo جذاب است؛ برای ویرایشهای بسیار حساس، مقایسه با مدل پایه منطقیتر خواهد بود.
مجوز Qwen-Image-2.1-viggle-turbo و استفاده تجاری
این موضوع برای کاربران حرفهای اهمیت زیادی دارد.
Qwen-Image-2.1-viggle-turbo اثری مشتقشده از Qwen-Image-2.1 است و تحت Qwen Research License Agreement منتشر شده است.
طبق متن مجوز درجشده در مخزن، استفاده غیرتجاری برای پژوهش و ارزیابی مجاز است و برای استفاده تجاری به مجوز جداگانه از صاحب مجوز نیاز است.
بنابراین اگر قصد استفاده از این مدل در محصول پولی، سرویس تجاری، پروژه مشتری یا فرایند درآمدزا را دارید، نباید صرفاً به در دسترس بودن فایل در Hugging Face استناد کنید. شرایط مجوز را پیش از استفاده تجاری مستقیماً بررسی کنید.
Qwen-Image-2.1-viggle-turbo برای چه کسانی مناسب است؟
این مدل بهویژه برای چند گروه میتواند جذاب باشد:
کاربرانی که روی کارت گرافیک خود مدلهای تولید تصویر اجرا میکنند و سرعت آزمایش پرامپت برایشان مهم است.
توسعهدهندگانی که میخواهند تعداد زیادی خروجی آزمایشی تولید کنند.
کاربران ComfyUI که به دنبال یک جریان کاری سریعتر برای Qwen-Image-2.1 هستند.
پژوهشگرانی که روی مدلهای تقطیرشده و کاهش تعداد مراحل نمونهبرداری مطالعه میکنند.
تولیدکنندگان محتوا و طراحانی که برای ایدهپردازی به خروجیهای متعدد و سریع نیاز دارند.
در مقابل، اگر هدف اصلی شما تولید نوشتههای بسیار ریز، ویرایش بسیار پیچیده چندمرجعی یا حفظ فوقدقیق هویت است، بهتر است مدل اصلی Qwen-Image-2.1 نیز در فرایند ارزیابی شما حضور داشته باشد.
جمعبندی؛ آیا Qwen Image 2.1 Viggle Turbo ارزش استفاده دارد؟
Qwen-Image-2.1-viggle-turbo نمونهای جالب از مسیری است که مدلهای تولید تصویر به سمت آن حرکت میکنند: رسیدن به کیفیت نزدیک به مدل اصلی با تعداد بسیار کمتری مرحله پردازشی.
نسخه v0.2.1 توانسته اجرای Qwen-Image-2.1 را از ۴۰ مرحله مقایسهای به ۶ مرحله برساند و طبق آزمایشهای سازنده، در بسیاری از نمونههای معمول اختلاف بصری محدودی با مدل پایه داشته باشد.
در مقابل، نوشتههای کوچک، ویرایشهای چندمرجعی پیچیده و حفظ دقیق هویت همچنان نقاطی هستند که باید با دقت بیشتری ارزیابی شوند.
اگر هدف شما آزمایش سریع پرامپت، تولید تعداد زیادی نمونه، کار با ComfyUI یا پژوهش درباره مدلهای تصویری سریع است، این نسخه ارزش بررسی جدی دارد.
اما برای استفاده حرفهای، سه موضوع را فراموش نکنید: نوع پروژه، کیفیت موردنیاز و محدودیت مجوز تجاری.
اگر میخواهید تولید تصویر با مدلهایی مانند Qwen، Flux و سایر ابزارهای جدید هوش مصنوعی را بهصورت اصولی یاد بگیرید، مسیر آموزش تولید تصویر با هوش مصنوعی در IR AI Academy میتواند نقطه بعدی یادگیری شما باشد.
سوالات متداول
آیا Qwen-Image-2.1-viggle-turbo از مدل اصلی سریعتر است؟
بله. طبق اندازهگیری منتشرشده توسط Viggle، نسخه v0.2.1 با ۶ مرحله در مقایسه با اجرای ۴۰ مرحلهای مدل پایه، در مجموع حدود ۵ برابر سریعتر بوده است. سرعت واقعی شما میتواند بسته به سختافزار، وضوح و تنظیمات متفاوت باشد.
آیا نسخه Turbo برای ویرایش تصویر مناسب است؟
بله. این مدل از ویرایش مبتنی بر دستور پشتیبانی میکند و در فرایند آموزش آن از حداکثر ۳ تصویر مرجع استفاده شده است. با این حال، ویرایشهای بسیار پیچیده و حساس به هویت ممکن است همچنان در مدل پایه نتیجه بهتری داشته باشند.
r128 بهتر است یا r256؟
r256 نسخه کاملتر LoRA است و r128 نسخه فشردهتر آن محسوب میشود. اگر حافظه و حجم فایل برای شما مهم است، r128 گزینه جذابی است؛ اگر محدودیت منابع ندارید و میخواهید به نسخه مرجع نزدیکتر باشید، r256 انتخاب محافظهکارانهتری است.
آیا میتوان از این مدل بهصورت تجاری استفاده کرد؟
براساس مجوز فعلی مخزن، استفاده تجاری نیازمند دریافت مجوز جداگانه است. پیش از استفاده در محصول یا خدمات پولی، آخرین متن Qwen Research License را بررسی کنید.
نظرات (۰)
هنوز نظری ثبت نشده است. اولین نفر باشید.