فهرست مطالب
- SynthID Detector در یک نگاه
- SynthID Detector چیست و عرضه عمومی آن چه تغییری ایجاد کرده است؟
- از نسخه محدود سال ۲۰۲۵ تا دسترسی عمومی سال ۲۰۲۶
- چرا یک وبسایت اختصاصی اهمیت دارد؟
- واترمارک SynthID چگونه کار میکند؟
- واترمارک در تصویر و ویدیو
- واترمارک در فایلهای صوتی
- تفاوت SynthID Text با ابزار عمومی جدید
- این آشکارساز چه فایلها و خروجیهایی را پشتیبانی میکند؟
- فرمتهای تصویر، ویدیو و صدا
- محصولات گوگل و شرکای پشتیبانیشده
- آموزش استفاده از SynthID Detector؛ از بارگذاری تا خواندن پاسخ
- پیش از ارسال فایل چه مواردی را بررسی کنیم؟
- مراحل انجام یک بررسی
- سه برداشت متفاوت از نتیجه
- محدودیتهای کلیدی: چرا SynthID Detector دستگاه حقیقتسنج نیست؟
- همه مدلهای هوش مصنوعی از SynthID استفاده نمیکنند
- واترمارکها مقاوم طراحی میشوند، نه شکستناپذیر
- سرویس عمومی ناحیه دقیق ویرایش را نشان نمیدهد
- حساب کاربری و سهمیه استفاده محدودیت عملی ایجاد میکنند
- SynthID چه تفاوتی با استاندارد C2PA و سایر روشهای تشخیص دارد؟
- چرا داشتن اطلاعات منشأ هم کافی نیست؟
- مقایسه عملی دو رویکرد
- چرا این خبر برای کاربران فارسیزبان و رسانهها مهم است؟
- چکلیست پیشنهادی برای تحریریه و تیم محتوا
- چشمانداز ابزارهای تشخیص محتوا؛ شفافیت بیشتر، نه قطعیت کامل
- جمعبندی: چگونه از SynthID Detector درست استفاده کنیم؟
گوگل در ۷ اکتبر ۲۰۲۶ (۱۵ مهر ۱۴۰۵) دسترسی عمومی به SynthID Detector را اعلام کرد؛ ابزار تحت وبی که برای بررسی وجود واترمارک نامرئی SynthID در تصویر، ویدیو و فایل صوتی طراحی شده است. این سرویس اکنون بهصورت جهانی و به زبان انگلیسی در دسترس قرار گرفته و علاوه بر خروجی ابزارهای خود گوگل، از محتوای سازگار با SynthID متعلق به شرکایی مانند OpenAI، NVIDIA و Kakao نیز پشتیبانی میکند. طبق اعلام گوگل، پشتیبانی از Apple در زمان انتشار این خبر هنوز در راه است.
این تحول به این معنا نیست که از این پس هر تصویر یا صدای جعلی با یک کلیک شناسایی میشود. SynthID Detector یک آشکارساز عمومیِ تمام محتوای ساختهشده با هوش مصنوعی نیست. این ابزار دنبال نشانهای مشخص میگردد که باید از قبل در فرایند تولید یا ویرایش محتوای سازگار جاسازی شده باشد. بنابراین نتیجه مثبت و نتیجه منفی آن هر دو به تفسیر دقیق نیاز دارند؛ بهویژه زمانی که قرار است براساس نتیجه درباره اصالت یک فایل تصمیمگیری شود. جزئیات اولیه این عرضه در اطلاعیه رسمی گوگل آمده است.
SynthID Detector در یک نگاه
موضوع | اطلاعات تأییدشده یا گزارششده |
|---|---|
تاریخ اعلام عرضه عمومی | ۷ اکتبر ۲۰۲۶، برابر با ۱۵ مهر ۱۴۰۵ |
اعلامکننده | Pushmeet Kohli، معاون علم و ابتکارات راهبردی Google DeepMind |
وبسایت ابزار | |
دامنه دسترسی | جهانی؛ رابط کاربری انگلیسی |
هزینه | استفاده رایگان طبق گزارش رسانههای فناوری |
نیاز به حساب | ورود با حساب Google، OpenAI یا Apple، بنا بر گزارش Ars Technica |
سهمیه گزارششده | حدود ۱۰ بررسی تصویر، ویدیو و صدا در روز برای هر کاربر |
رسانههای قابل بررسی | تصویر، ویدیو و صدا؛ نه متن در نسخه عمومی جدید |
شرکای اعلامشده | OpenAI، NVIDIA، Kakao؛ پشتیبانی Apple در آینده |
محدودیت مهم | نبود واترمارک، اصالت فایل را اثبات نمیکند |
این جدول خلاصهای از اطلاعات منتشرشده در وبلاگ گوگل، گزارش Ars Technica و پوشش TechCrunch است. برخی جزئیات عملیاتی مانند سهمیه، ممکن است با سیاستهای سرویس تغییر کنند و نباید بهعنوان تعهد دائمی تلقی شوند.
SynthID Detector چیست و عرضه عمومی آن چه تغییری ایجاد کرده است؟
SynthID Detector یک درگاه راستیآزمایی رسانه است. کاربر فایلی را در اختیار سرویس قرار میدهد و سرویس بررسی میکند آیا در آن نشانهای از واترمارک SynthID وجود دارد یا خیر. در زبان ساده، بهجای آنکه الگوریتم صرفاً از روی شکل چهره، نورپردازی، نویز صدا یا ظاهر پیکسلها حدس بزند فایل مصنوعی است، یک نشانگر فنی از پیش جاسازیشده را جستوجو میکند. همین تفاوت درک تواناییها و محدودیتهای ابزار را آسانتر میسازد.
از نسخه محدود سال ۲۰۲۵ تا دسترسی عمومی سال ۲۰۲۶
گوگل در مه ۲۰۲۵ نسخه اولیه SynthID Detector را برای گروهی از روزنامهنگاران، پژوهشگران و متخصصان رسانه معرفی کرده بود. آن نسخه، آزمایشی و محدود بود و در توصیف اولیهاش از امکانات دقیقتری برای نمایش بخشهای دارای واترمارک سخن گفته میشد. معرفی رسمی نسخه اولیه نشان میدهد گوگل از همان زمان تشخیص محتوای مصنوعی را مسئلهای چندرسانهای میدانست.
در اکتبر ۲۰۲۶، دو تغییر اصلی رخ داد: نخست، درگاه اختصاصی برای استفاده عمومی گشوده شد؛ دوم، بررسی واترمارکهای سازگارِ شرکای گوگل نیز در یک نقطه جمع شد. بنا بر گزارش Ars Technica، پیشتر نسخه گوگلی آشکارساز لزوماً علامتهای نسخههای متمایز شرکا را شناسایی نمیکرد و برای کاربران خارج از برنامه آزمایشی، پرسیدن از Gemini یکی از راههای بررسی بود.
چرا یک وبسایت اختصاصی اهمیت دارد؟
دسترسی به یک درگاه مشخص، بررسی رسانه را برای کاربری که قصد گفتوگو با دستیار هوش مصنوعی ندارد سادهتر میکند. یک خبرنگار میتواند فایل دریافتی را در جریان بررسی اولیه خبر ارزیابی کند و یک تیم محتوا میتواند پیش از انتشار، وجود واترمارک را در فایل تولیدشده یا دریافتی ثبت کند. در عین حال این تمرکز مزیتی فنی هم دارد: کاربر مجبور نیست برای هر شرکت، شیوه تشخیص جداگانهای را جستوجو کند؛ البته فقط تا جایی که شرکت سازنده واقعاً از فناوری سازگار پشتیبانی کرده باشد.
واترمارک SynthID چگونه کار میکند؟
گوگل فناوری SynthID را در سال ۲۰۲۳ معرفی کرد. هدف آن افزودن یک علامت دیجیتال نامحسوس به خروجی هوش مصنوعی است؛ علامتی که چشم و گوش انسان در استفاده معمول متوجه آن نمیشود، ولی سامانه تشخیص سازگار میتواند آن را بررسی کند. در صفحه رسمی Google DeepMind درباره SynthID توضیح داده شده که این فناوری برای تصویر، ویدیو، صدا و حتی متن، روشهای متناسب با ماهیت هر رسانه دارد.
واترمارک در تصویر و ویدیو
در تصاویر، علامت در ساختار خود دادههای تصویری تعبیه میشود، نه صرفاً در نام فایل یا متادیتای قابل حذف آن. در ویدیو نیز میتوان بخشهایی از محتوای تصویری را به این شکل نشانهگذاری کرد. به گفته گوگل، واترمارک طوری طراحی شده که برخی تغییرات متعارف، ازجمله برش تصویر، اعمال فیلتر، تغییر نرخ فریم و فشردهسازیِ همراه با افت کیفیت را تحمل کند. «طراحیشده برای مقاومت» البته به معنی تضمین بقای علامت در هر نوع بازپردازش یا دستکاری نیست.
واترمارک در فایلهای صوتی
برای صدا، نشانگر نامحسوس در داده صوتی قرار میگیرد و هدف این است که کیفیت شنیداری معمول را مختل نکند. برای مثال، صدای تولیدشده بهوسیله یک ابزار سازگار میتواند در بررسی بعدی، نشانهای از منشأ تولید خود داشته باشد. با این همه، تبدیلهای شدید، نویز، ترکیب چند منبع صوتی یا ویرایشهای پیچیده ممکن است کیفیت تشخیص را تحت تأثیر قرار دهند. بنابراین حتی درباره رسانههایی که اصولاً از SynthID استفاده میکنند نیز نباید از دقت صددرصدی سخن گفت.
تفاوت SynthID Text با ابزار عمومی جدید
اینجا یک تمایز مهم وجود دارد: خود فناوری SynthID برای متن هم توسعه یافته است، اما سرویس عمومی جدیدِ SynthID Detector در اعلام عرضه اکتبر ۲۰۲۶ برای بررسی تصویر، ویدیو و صدا معرفی شده است. روش واترمارک متنی با تغییر کنترلشده احتمال انتخاب توکنها در هنگام تولید متن عمل میکند؛ شیوهای متفاوت با نشانهگذاری پیکسل یا سیگنال صوتی. گوگل بخشی از فناوری متن را نیز برای توسعهدهندگان متنباز کرده است. توضیح فنی را میتوان در مستندات رسمی SynthID Text مطالعه کرد.
این تفاوت برای خوانندگان IRAIAcademy اهمیت عملی دارد. موضوع این خبر را نباید با بحث واترمارک متن ChatGPT یکسان دانست. حتی اگر دو سامانه هر دو از واژه «واترمارک» استفاده کنند، ممکن است سازوکار، دامنه تشخیص و سیاست دسترسی آنها کاملاً متفاوت باشد.
این آشکارساز چه فایلها و خروجیهایی را پشتیبانی میکند؟
دامنه محصول در وهله نخست به فرمت فایل محدود میشود و سپس به منشأ تولید آن بستگی دارد. پشتیبانی از یک فرمت، مثلاً PNG، لزوماً به این معنی نیست که هر تصویر PNG ساختهشده با هوش مصنوعی شناسایی خواهد شد. فایل باید واترمارک سازگار داشته باشد و نشانگر آن در شرایط قابلتشخیص باقی مانده باشد.
فرمتهای تصویر، ویدیو و صدا
براساس فهرستی که TechCrunch از نسخه وب منتشر کرده، قالبهای شناختهشده زیر قابل ارسالاند:
نوع فایل | پسوندهای گزارششده |
|---|---|
تصویر | JPG، JPEG، PNG، BMP، WEBP، AVIF، HEIC، HEIF، TIFF، TIF و GIF |
ویدیو | MP4، MOV و WEBM |
صدا | WAV، MP3، OGG، FLAC، AAC و M4A |
این فهرست درباره قالب است و نباید با حد مجاز حجم فایل یا تضمین موفقیت بارگذاری اشتباه شود. قبل از هر بررسی، بهتر است نسخه باکیفیت و تا حد امکان نزدیک به فایل اصلی انتخاب شود؛ زیرا فایلهای چندبار بازنشرشده، فشرده یا تبدیلشده ممکن است نشانههای فنی کمتری برای ارزیابی داشته باشند.
محصولات گوگل و شرکای پشتیبانیشده
مطابق گزارشهای منتشرشده، فناوری واترمارک در خروجی برخی ابزارهای گوگل مانند Nano Banana، Veo و Lyria و سرویسهایی نظیر Gemini، Flow، ProducerAI و Vids استفاده میشود. البته بهکارگیری این فناوری در یک خانواده محصول، به معنی آن نیست که تمام خروجیهای تاریخی، همه نسخهها یا هر قابلیت آن خانواده الزاماً نشانگر یکسان داشتهاند. برای آشنایی با یکی از خانوادههای تصویرساز میتوان مطلب Nano Banana و برای پیگیری تحولات مدلها صفحه Gemini را در IRAIAcademy دنبال کرد.
گوگل در اطلاعیه عرضه عمومی، OpenAI، NVIDIA و Kakao را در کنار محصولات خودش نام برده است. پشتیبانی از Apple با عبارت «بهزودی» اعلام شده و نباید پیش از انتشار تأیید رسمیِ تکمیل آن، در جدول قابلیتهای فعال قرار گیرد. درباره قابلیتهایی مانند Image Playground نیز Engadget به پشتیبانی آینده اشاره کرده است، نه دسترسی قطعی در روز عرضه.
آموزش استفاده از SynthID Detector؛ از بارگذاری تا خواندن پاسخ
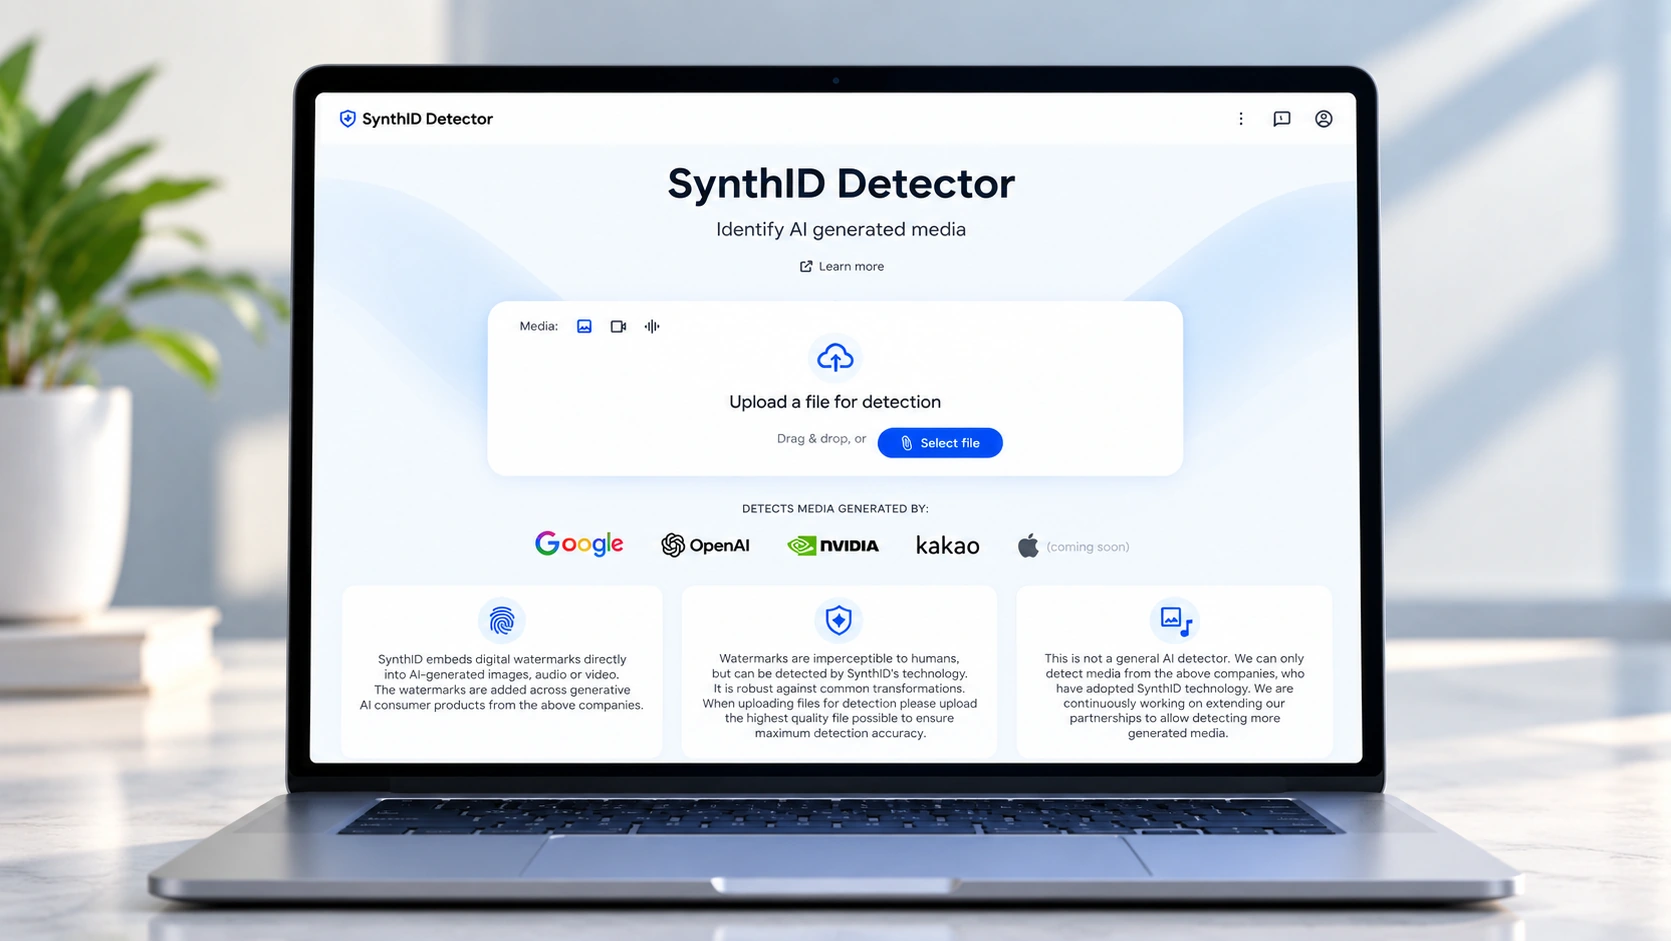
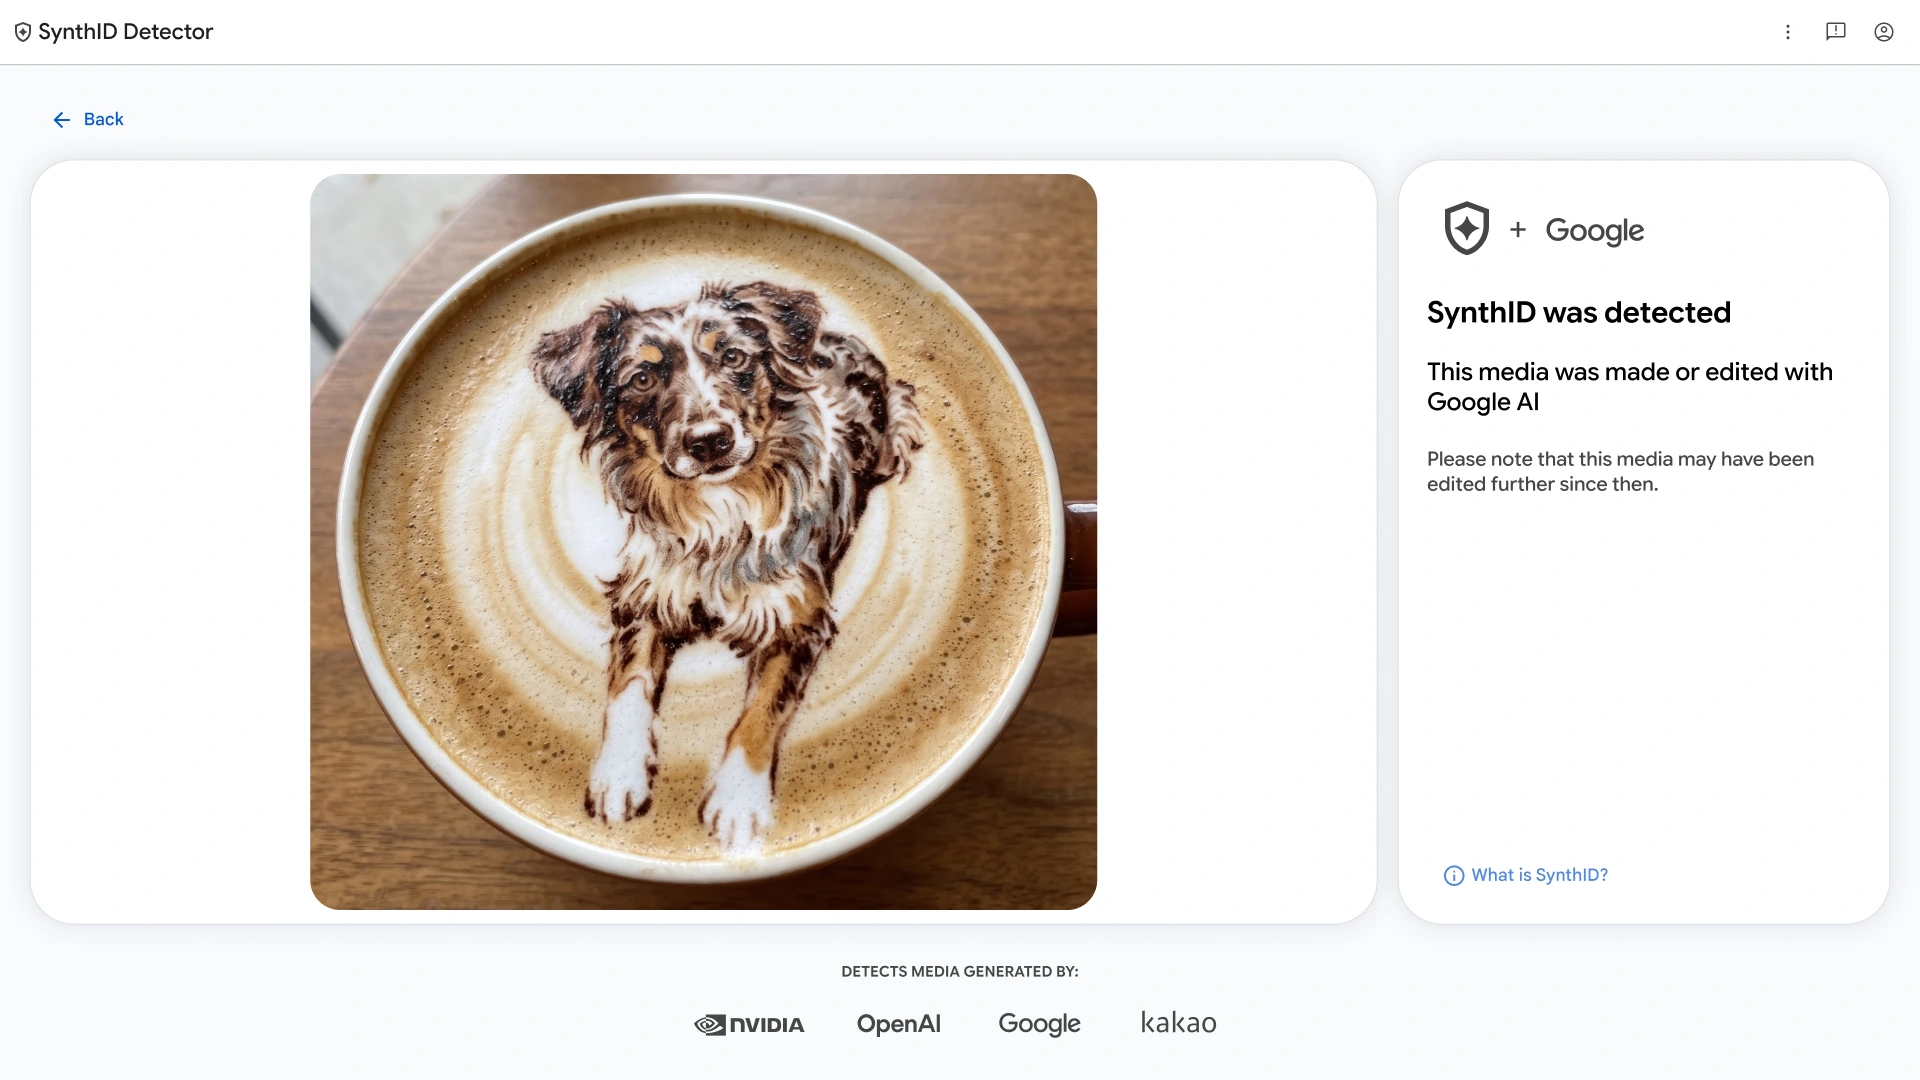
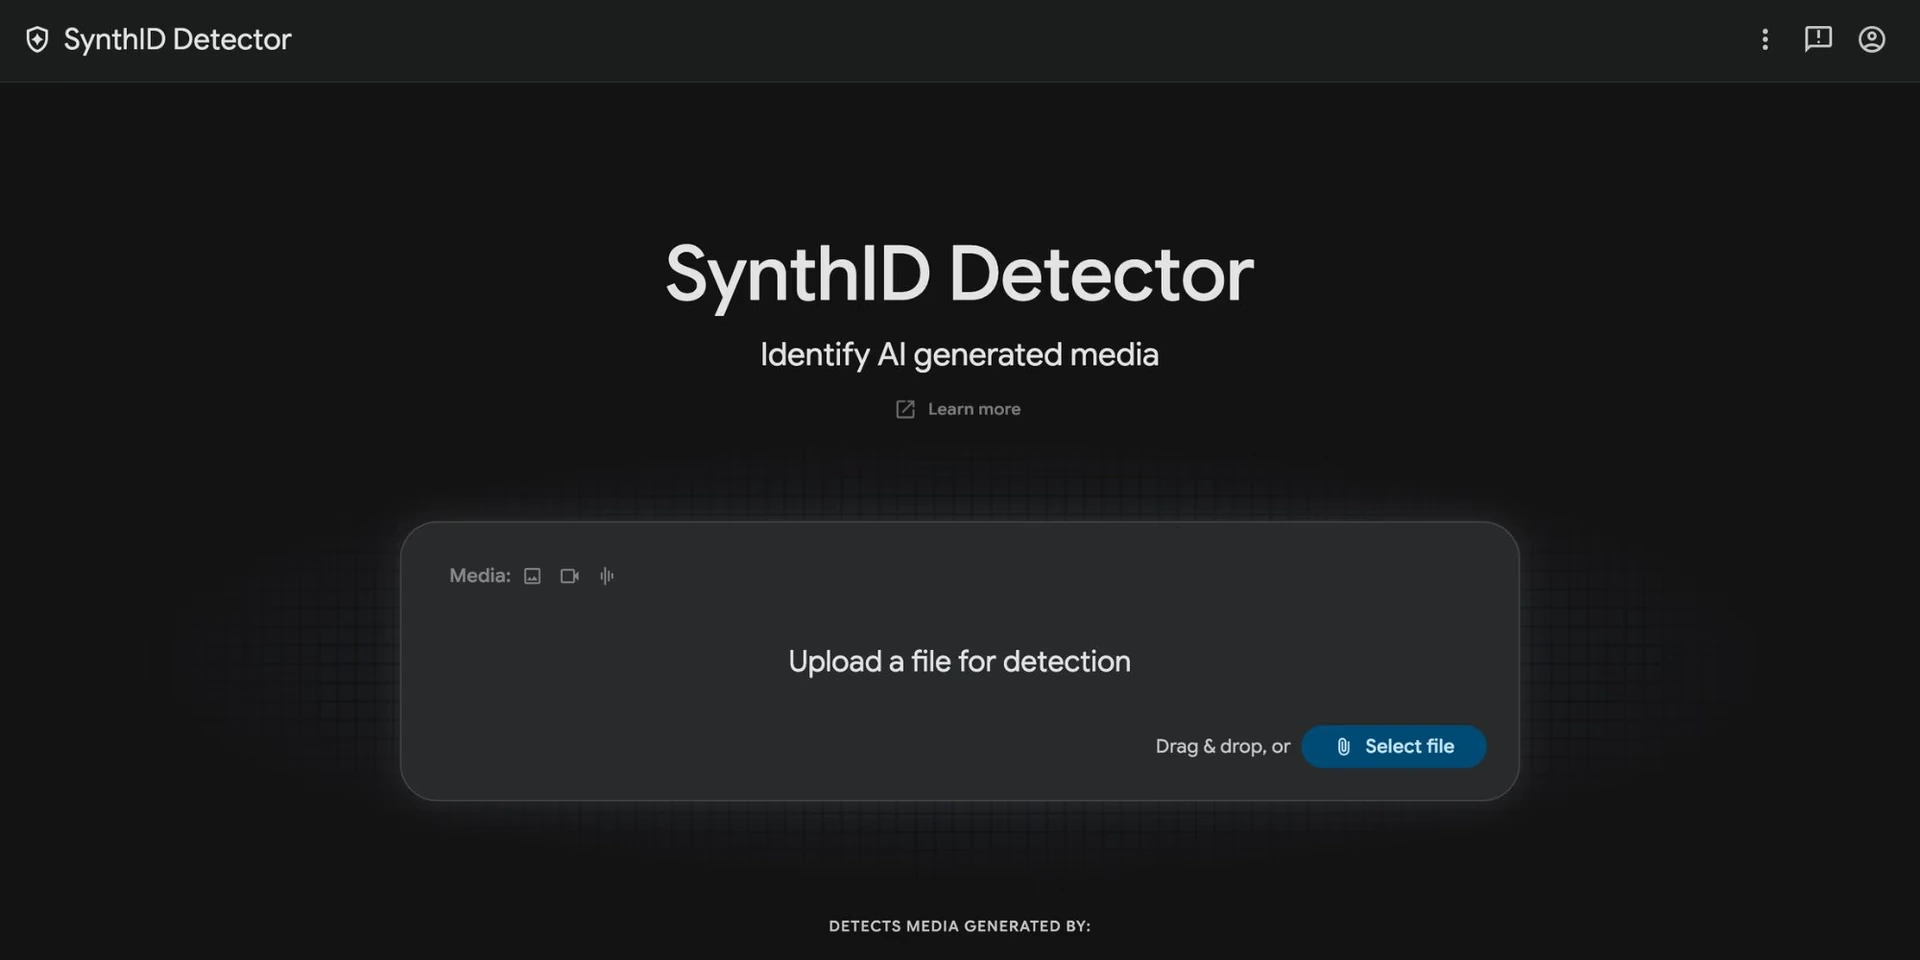
برای شروع، وارد وبسایت SynthID Detector شوید. بنا بر اطلاعات منتشرشده در زمان عرضه، استفاده از سرویس رایگان است، ولی برای بررسی فایل باید با یکی از حسابهای Google، OpenAI یا Apple وارد شوید. سپس نوع فایل مناسب را انتخاب و رسانه موردنظر را بارگذاری کنید. سرویس وجود یا نبود نشانگر قابلشناسایی را بررسی میکند و نتیجه را در همان محیط نمایش میدهد.
پیش از ارسال فایل چه مواردی را بررسی کنیم؟
مطمئن شوید حق بارگذاری فایل را دارید و محتوای آن شامل دادههای شخصی، محرمانه یا اطلاعات حساس دیگران نیست. برای راستیآزمایی فایل کاری یا سند درونسازمانی، سیاستهای حریم خصوصی و شرایط سرویس را جداگانه بخوانید. بهتر است بهجای نسخهای که چند بار در پیامرسانها بازفشردهسازی شده، نسخه اصلی یا باکیفیتتری از همان محتوا را آزمایش کنید. نتیجه آزمایش، نام فایل، تاریخ بررسی و زمینه دریافت محتوا را نیز در پرونده راستیآزمایی خود ثبت کنید.
مراحل انجام یک بررسی
۱. نشانی رسمی synthid.com را باز کنید و فرایند ورود به حساب را کامل کنید.
۲. رسانه موردنظر را با فرمت پذیرفتهشده انتخاب کنید؛ اگر چند نسخه در اختیار دارید، نخست فایل اصلی یا نسخه کمتغییرتر را بررسی کنید.
۳. پیام نهایی را بخوانید و در صورت ضرورت، اسکرینشات نتیجه را همراه با زمان بررسی نگه دارید.
۴. نتیجه را با سایر شواهد، ازجمله منبع نخستین انتشار، سوابق ویرایش و محتوای ادعای همراه فایل تطبیق دهید. از یک پیام مثبت یا منفی بهتنهایی حکم قطعی درباره واقعیت رویداد صادر نکنید.
سه برداشت متفاوت از نتیجه
وقتی واترمارک شناسایی میشود
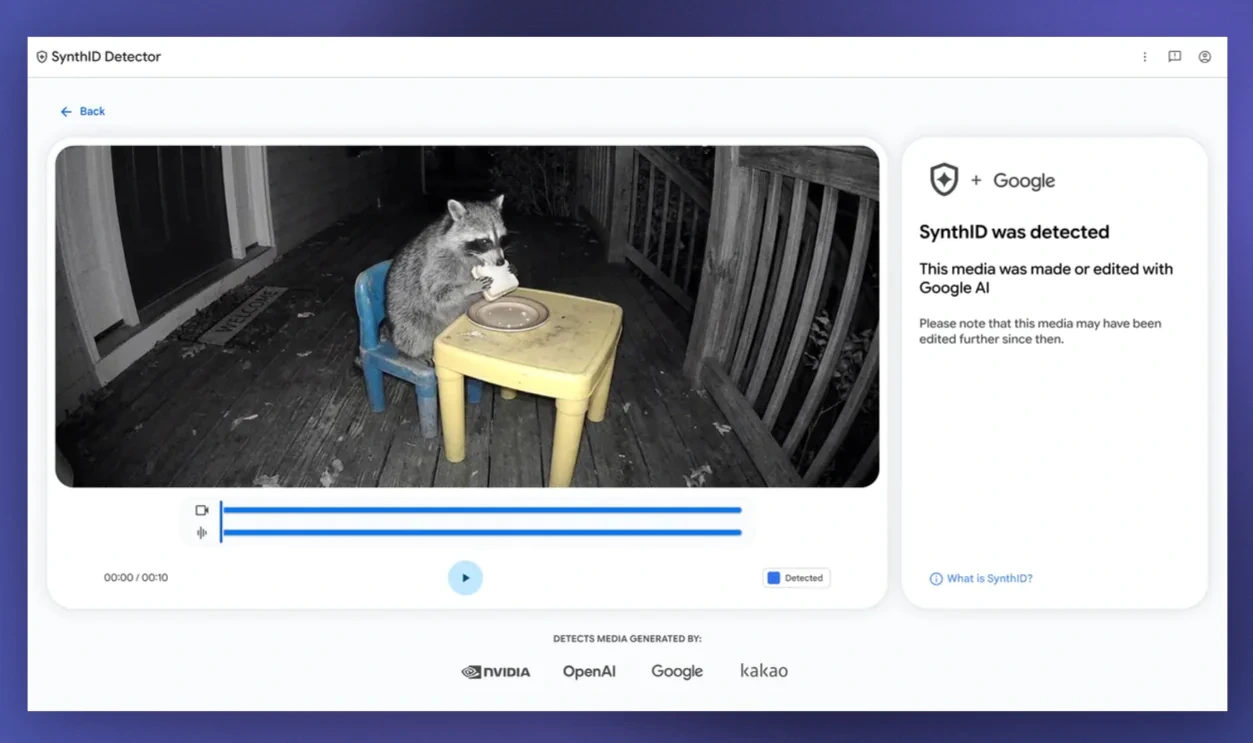
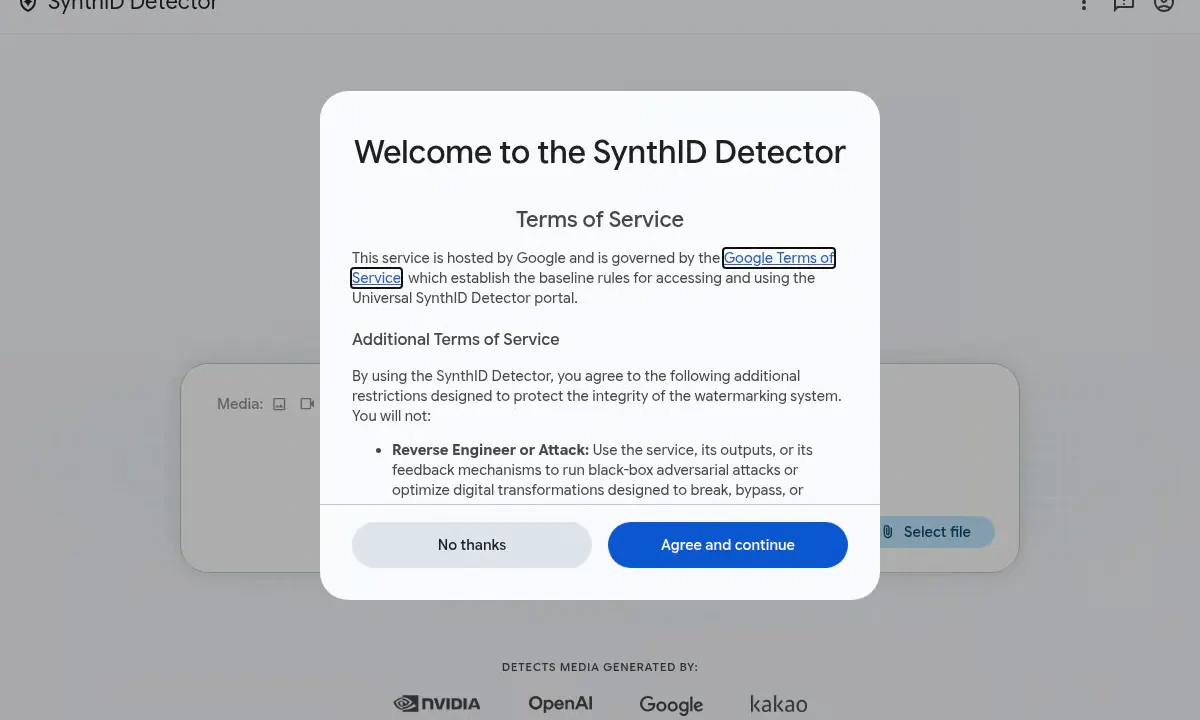
در نمونه رسمی گوگل، پیام «SynthID was detected» همراه با توضیحی درباره ساختهشدن یا ویرایش رسانه با هوش مصنوعی سازگار دیده میشود. این یافته شاهدی درباره دخالت یکی از ابزارهای پشتیبانیشده در فرایند تولید یا ویرایش است؛ اما لزوماً نمیگوید تمام پیکسلها، همه ثانیههای ویدیو یا کل صدای موجود مصنوعی هستند. همان فایل ممکن است بعدها با نرمافزار دیگری نیز دستکاری شده باشد.
وقتی واترمارک شناسایی نمیشود
عبارت «تشخیص داده نشد» را باید محدود به همین آزمون فهمید. ممکن است فایل کاملاً طبیعی باشد؛ ممکن است خروجی ابزاری باشد که اصلاً SynthID ندارد؛ و ممکن است بخشی از نشانهها در اثر ویرایش یا تبدیل فایل قابلتشخیص نباشند. بنابراین پاسخ منفی نه اثبات انسانی بودن محتواست، نه تضمین واقعی بودن رویداد نشاندادهشده.
وقتی نتیجه برای تصمیمگیری کافی نیست
گاهی حتی با یافتن واترمارک، پرسش اصلی پاسخ نمیگیرد. برای مثال ممکن است تصویری واقعی با ابزار هوش مصنوعی اصلاح رنگ یا بازسازی شده باشد. در این حالت، وجود علامت فنی چیزی درباره درست یا نادرست بودن شرح همراه عکس نمیگوید. اگر هدف تشخیص جعل یک رویداد سیاسی، یک پیام صوتی بانکی یا محتوای آسیبزننده به اعتبار فرد است، بررسی اصالت و زمینه انتشار باید مستقل ادامه یابد.
محدودیتهای کلیدی: چرا SynthID Detector دستگاه حقیقتسنج نیست؟
همه مدلهای هوش مصنوعی از SynthID استفاده نمیکنند
مهمترین مرز این ابزار، خود اکوسیستم واترمارک است. برخی شرکتها استانداردهای متفاوتی را دنبال میکنند و برخی سامانهها ممکن است هیچ واترمارک قابلبررسی عمومی نگذارند. اجرای مدلهای دارای وزن قابلدسترسی روی سختافزار شخصی نیز میتواند محتوایی بسازد که فاقد نشانگر مورد انتظار این سرویس باشد. بنابراین شناسایی نشدن فایل را نمیتوان به تمام جهان ابزارهای مولد تعمیم داد. مثالهای جدید این اکوسیستم را میتوان در بحث مدلهای تصویرساز متنباز و ابزارهای ویدیویی دنبال کرد.
واترمارکها مقاوم طراحی میشوند، نه شکستناپذیر
مقاومت در برابر برش، فشردهسازی و تغییرات متعارف، مزیت مهمی برای هر فناوری واترمارک است؛ اما نتیجه تشخیص به شدت تغییرات و شرایط فایل بستگی دارد. کپیبرداری از تصویر نمایشگر، بازسازی فایل، ویرایش سنگین یا ترکیب چند منبع میتواند شرایط متفاوتی ایجاد کند. بدون داشتن آمار آزمون مستقل برای هر رسانه و هر سناریو نمیتوان درصد دقتی کلی برای تمام موارد اعلام کرد. گزارشهای TechCrunch و Engadget نیز بر محدودیت شناسایی تأکید کردهاند.
سرویس عمومی ناحیه دقیق ویرایش را نشان نمیدهد
برخلاف توضیح نسخه آزمایشی سال ۲۰۲۵ که میتوانست نواحی یا بخشهای مشکوک به داشتن واترمارک را برجسته کند، گزارشهای عرضه عمومی سال ۲۰۲۶ میگویند خروجی وبسایت جدید عمدتاً پیام وجود یا نبود واترمارک است. این پیام به خودی خود مشخص نمیکند آیا تصویر از صفر تولید شده یا تنها بخشی از آن با هوش مصنوعی ویرایش شده است. همچنین از آن نباید انتظار جدول زمانی دقیقِ بخشهای ساختگی ویدیو یا نقشه دستکاری پیکسلبهپیکسل داشت.
حساب کاربری و سهمیه استفاده محدودیت عملی ایجاد میکنند
با وجود دسترسی عمومی، استفاده بدون حساب در زمان عرضه امکانپذیر گزارش نشده است. Ars Technica سهمیهای حدود ۱۰ بررسی روزانه را نقل کرده و توضیح داده محدودیت درخواستها به جلوگیری از آزمونهای پیدرپی برای یافتن روش دورزدن واترمارک مربوط است. عدد «حدود» مهم است؛ نباید آن را سقف ثابت و تضمینشده برای همه حسابها، فرمتها و شرایط استفاده تلقی کرد.
SynthID چه تفاوتی با استاندارد C2PA و سایر روشهای تشخیص دارد؟
در رویکرد واترمارک، یک نشانه در خود محتوای تولیدشده یا ساختار خروجی قرار میگیرد تا بعداً توسط سامانه مناسب پیدا شود. در مقابل، استاندارد C2PA بر ثبت و انتقال اطلاعات منشأ و تاریخچه تغییرات رسانه در قالب «اعتبارنامه محتوا» یا Content Credentials تمرکز دارد. این دو رویکرد یکسان نیستند و لزوماً جایگزین کامل یکدیگر محسوب نمیشوند. یکی میخواهد نشانهای از فرایند تولید را در رسانه نگه دارد؛ دیگری میکوشد اطلاعات مربوط به مسیر تولید و ویرایش را بهشکل قابلبررسی همراه آن ارائه کند.
چرا داشتن اطلاعات منشأ هم کافی نیست؟
اعتبارنامه فنی میتواند اطلاعات مفیدی درباره سازنده، ابزار یا تغییرات ثبتشده فراهم کند، اما بهخودیخود صحت تمام ادعاهای داخل یک عکس یا ویدیو را تضمین نمیکند. یک فایل ممکن است واقعاً از دوربین آمده باشد ولی در زمان یا مکان اشتباهی منتشر شود. برعکس، حذفشدن متادیتا در یک پیامرسان ضرورتاً نشانه جعلی بودن نیست. ایده مطرحشده در گزارش Ars Technica نیز این است که ثبت منشأ رسانه واقعی در کنار شناسایی رسانه مصنوعی میتواند به تصویر کاملتری از اعتبار محتوا کمک کند.
مقایسه عملی دو رویکرد
معیار | SynthID | C2PA / Content Credentials |
|---|---|---|
موضوع اصلی | یافتن واترمارک سازگار در محتوا | بررسی اطلاعات منشأ و ویرایشِ ثبتشده |
شرط اصلی | وجود و باقیماندن نشانگر SynthID | وجود و حفظ اعتبارنامه و زنجیره اطلاعات مربوط |
خروجی | نشانهای از دخالت ابزار سازگار | اطلاعات قابلارائه درباره منشأ یا سوابق ثبتشده |
نتیجه منفی | اثبات واقعی بودن نیست | اثبات جعلی بودن نیست |
کاربرد بهتر | یکی از شواهد بررسی خروجی هوش مصنوعی | تکمیل سابقه تولید و ویرایش محتوا |
در یک فرایند حرفهای، بررسی واترمارک و اعتبارنامه فقط دو قطعه از پرونده شواهدند. تطبیق ادعا با منابع مستقل، بررسی زمان انتشار، بررسی نسخه اصلی و ارزیابی زمینه همچنان ضروری است. هیچکدام از این ابزارها بهتنهایی مسئولیت تصمیم نهایی را از دوش راستیآزما یا سردبیر برنمیدارند.
چرا این خبر برای کاربران فارسیزبان و رسانهها مهم است؟
تصاویر ساختهشده با هوش مصنوعی، کلیپهای دستکاریشده و صداهای شبیهسازیشده میتوانند با توضیحی قانعکننده در کانالها و شبکههای اجتماعی منتشر شوند. مخاطب فارسیزبان معمولاً فقط نسخه بازنشرشده را میبیند و ممکن است به فایل اصلی، مشخصات دوربین یا تاریخچه ویرایش دسترسی نداشته باشد. در چنین شرایطی یک آزمایش فنی سریع، هرچند محدود، میتواند نقطه شروع خوبی برای تصمیم درباره ادامه بررسی باشد؛ نه پایان آن.
برای مثال، فرض کنید ویدیویی از سخنرانی شخصی شناختهشده در یک گروه منتشر شده است. شناسایی SynthID میتواند نشان دهد رسانه در فرایندی سازگار با این فناوری تولید یا ویرایش شده؛ اما درباره محتوای واقعی سخنرانی، زمان ضبط یا نیت انتشار آن اطلاعات کاملی نمیدهد. اگر واترمارکی پیدا نشد نیز باید نسخه اصلی، منبع اولیه، رسانههای دیگر و شواهد مستقل بررسی شوند. همین منطق در مورد صدای منتسب به مدیر شرکت یا تصاویر تبلیغاتی گمراهکننده صدق میکند.
گسترش ابزارهایی مانند آواتار ویدیویی هوش مصنوعی پرسشهای تازهای درباره رضایت فرد، بیان شفاف استفاده از هوش مصنوعی و امکان سوءبرداشت ایجاد کرده است. کاربرد اخلاقی این فناوری لزوماً مشکلآفرین نیست؛ مشکل زمانی پدید میآید که مخاطب درباره منشأ یا ماهیت رسانه گمراه شود. از این رو سازمانها بهتر است همراه با استفاده از ابزار تشخیص، سیاست روشنی برای برچسبگذاری و مستندسازی محتوای تولیدی خود تدوین کنند.
چکلیست پیشنهادی برای تحریریه و تیم محتوا
پیش از تأیید نهایی یک تصویر، ویدیو یا صدا، ابتدا مشخص کنید دقیقاً چه ادعایی باید راستیآزمایی شود؛ اصالت رسانه، هویت گوینده، زمان وقوع حادثه یا درستی توضیح همراه فایل. سپس منبع نخستین انتشار را جستوجو کنید، نسخههای متفاوت را کنار هم بگذارید و در صورت امکان نسخه باکیفیتتر را دریافت کنید. بعد میتوانید SynthID Detector را بهعنوان یک آزمون مکمل به کار ببرید و نتیجه، تاریخ و شرایط آن را ثبت کنید.
اگر رسانه در یک تصمیم حساس به کار میرود، به یک خروجی بسنده نکنید. وجود واترمارک را با شواهد دیگر بسنجید و در صورت نبود علامت، بررسی را متوقف نکنید. در نهایت، هنگام انتشار نتیجه را با زبانی دقیق توضیح دهید: «واترمارک شناسایی شد» با «تمام این ویدیو جعلی است» تفاوت دارد؛ همانطور که «واترمارک یافت نشد» با «این تصویر واقعی و دستنخورده است» یکسان نیست.
چشمانداز ابزارهای تشخیص محتوا؛ شفافیت بیشتر، نه قطعیت کامل
گوگل میگوید از زمان معرفی SynthID تاکنون بیش از ۱۸۰ میلیارد تصویر و ویدیو و معادل ۲۴۰ هزار سال محتوای صوتی را با این فناوری نشانهگذاری کرده است. این ارقام در اطلاعیه ۷ اکتبر ۲۰۲۶ گزارش شدهاند و نشاندهنده مقیاس استفاده اعلامی گوگل هستند، نه تعداد فایلهایی که وبسایت جدید مستقلاً آزمایش کرده است. گوگل همچنین اعلام کرده قابلیتهای بررسی تعبیهشده در Search، Gemini و Chrome روزانه بیش از یک میلیون درخواست را پردازش میکنند؛ این عدد هم به مجموعه قابلیتهای داخلی مربوط است، نه لزوماً مراجعهکنندگان وبسایت تازه.
مهمتر از حجم استفاده، تغییر نگاه به شفافیت در تولید رسانه است. احتمال دارد در آینده ابزارها، استانداردها و شرکتهای بیشتری به سازوکارهای مشترک بپیوندند. با این حال در زمان این خبر، پشتیبانی از شرکتهای اعلامشده و دامنه مشخص رسانهها تنها مواردیاند که میتوان با اطمینان گزارش کرد. افزودن نام شرکای احتمالی، وعده تشخیص همه دیپفیکها یا اعلام درصد دقت بدون داده آزمون، به کاربر تصویری نادرست از قابلیت واقعی سرویس میدهد.
جمعبندی: چگونه از SynthID Detector درست استفاده کنیم؟
عرضه عمومی SynthID Detector قدمی مهم در آسانترشدن بررسی نشانگر محتوای ساخته یا ویرایششده با هوش مصنوعی است. دسترسی جهانی، یک درگاه اختصاصی و پشتیبانی از واترمارکهای چند شرکت، ارزش عملی ابزار را بیشتر کردهاند. با وجود این، تشخیص فقط به رسانههای دارای واترمارک سازگار محدود است؛ ابزار عمومی جدید متن را بررسی نمیکند، جزئیات دقیق بخشهای مصنوعی را نشان نمیدهد و درباره اصالت نهایی فایل حکم صادر نمیکند.
قاعده کاربردی این است: نتیجه مثبت را شاهد دخالت ابزار سازگار بدانید و نتیجه منفی را صرفاً نبود علامت قابلشناسایی تفسیر کنید. برای تصمیم حرفهای، این داده باید کنار بررسی منشأ، زمان، زمینه انتشار و سایر شواهد قرار گیرد. اگر تیم رسانهای یا سازمان شما در حال طراحی فرایند بررسی و استفاده مسئولانه از این ابزارهاست، میتوانید موضوع را در چارچوب مشاوره هوش مصنوعی نیز پیگیری کنید.
سوالات متداول
آیا SynthID Detector رایگان است؟
بنا بر گزارش رسانههای فناوری از عرضه اکتبر ۲۰۲۶، استفاده از آن رایگان است؛ اما ورود با حساب Google، OpenAI یا Apple نیاز دارد. Ars Technica سهمیهای در حدود ۱۰ بررسی در روز گزارش کرده است و میزان دقیق ممکن است متغیر باشد.
آیا SynthID Detector هر تصویر یا ویدیوی هوش مصنوعی را تشخیص میدهد؟
خیر. این ابزار نشانه SynthID سازگار را بررسی میکند. فایلهای تولیدشده با ابزارهایی که این واترمارک را به کار نمیگیرند، یا فایلهایی که نشانگرشان دیگر قابلتشخیص نیست، ممکن است نتیجه منفی بگیرند.
آیا نتیجه «تشخیص داده نشد» به معنی واقعی بودن فایل است؟
خیر. این پیام تنها میگوید واترمارک قابلشناسایی SynthID در آن بررسی پیدا نشده است و بهتنهایی اصالت، انسانی بودن یا صحت محتوای فایل را تأیید نمیکند.
آیا تصاویر ساختهشده با ChatGPT را تشخیص میدهد؟
نسخه عمومی جدید از واترمارکهای سازگار شرکای گوگل، ازجمله OpenAI، پشتیبانی میکند. بااینحال همه تصاویر تاریخی ChatGPT لزوماً واترمارک قابلشناسایی ندارند و نتیجه هر فایل به زمان تولید، ابزار و وضعیت نشانگر وابسته است.
آیا این سایت متن ساختهشده با هوش مصنوعی را بررسی میکند؟
خیر، در زمان عرضه عمومی اکتبر ۲۰۲۶ درگاه جدید برای تصویر، ویدیو و صدا معرفی شده است. البته SynthID یک فناوری مجزا برای واترمارکگذاری متن نیز دارد؛ این دو موضوع را نباید یکسان دانست.
آیا مشخص میکند کدام قسمت تصویر یا ویدیو با هوش مصنوعی ساخته شده است؟
در نسخه عمومی جدید، گزارشهای موجود خروجی را عمدتاً پیام وجود یا نبود واترمارک توصیف میکنند. برخلاف برخی قابلیتهای نسخه آزمایشی قبلی، تعیین ناحیه دقیق ویرایش یا تشخیص ساخت کامل از ویرایش جزئی تضمین نمیشود.
نظرات (۰)
هنوز نظری ثبت نشده است. اولین نفر باشید.